Research Papers

最新机器人研究的通俗英语摘要,涵盖人形机器人、四足机器人、工业自动化和人工智能。
499 论文
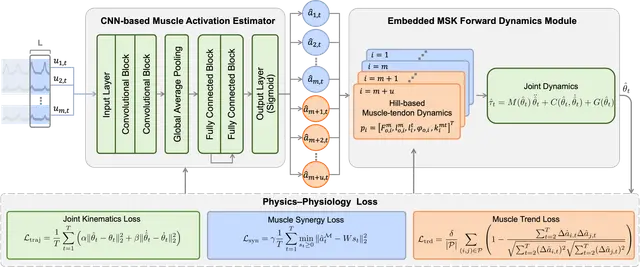
生理约束神经网络从部分肌肉信号估计手腕运动
Robotics6月8日

生理约束神经网络从部分肌肉信号估计手腕运动

一种受生理约束的肌肉骨骼神经网络从部分观测的sEMG信号中估计多自由度手腕运动学,集成肌肉骨骼模型。

Wending Heng, Mingming Zhang, Glen Cooper, Zhenhong Li

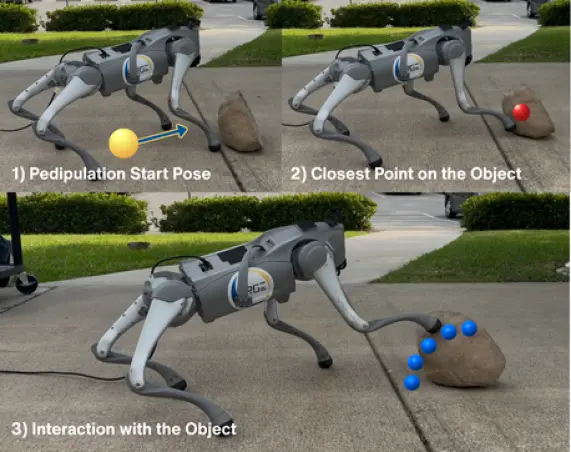
用脚推拉物体的四足机器人:一种更智能的训练方法
Robotics6月8日

用脚推拉物体的四足机器人:一种更智能的训练方法

我们提出了一种分层强化学习框架,使四足机器人能够用脚操控物体——这种能力称为足部操控。

Tuba Girgin, Jose Castelblanco, Gabriel Rodriguez +2

无需重新训练机器人的流式策略调整方法
Robotics6月7日

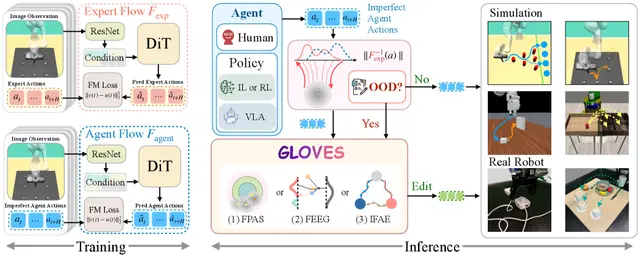
无需重新训练机器人的流式策略调整方法

基于流的动作适应方法无需重新训练机器人,利用有限专家演示进行选择性异常门控修正,在仿真和真实机器人上均有效。

Luzhe Sun, Jingtian Ji, Haoran Chen +2

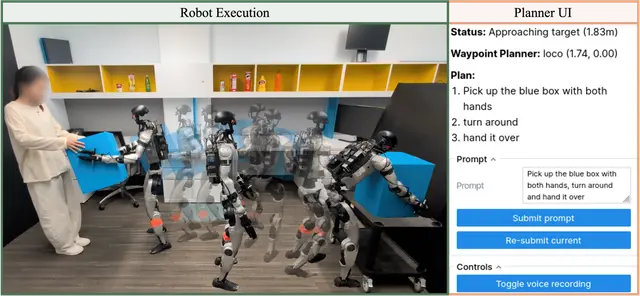
速度可控的机器人策略:TempoVLA 让您自由调节执行速度
AI6月7日

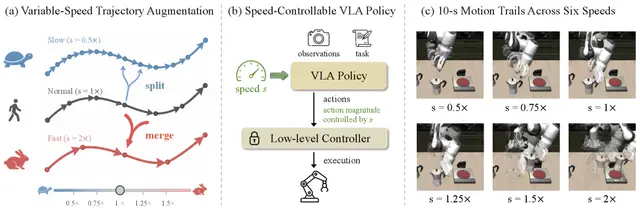
速度可控的机器人策略:TempoVLA 让您自由调节执行速度
Dong Jing, Jingchen Nie, Tianqi Zhang +4

HANDOFF:人形机器人一个控制器即可实现行走、操作与恢复
Humanoid6月7日

HANDOFF:人形机器人一个控制器即可实现行走、操作与恢复
Lizhi Yang, Junheng Li, Nehar Poddar +5

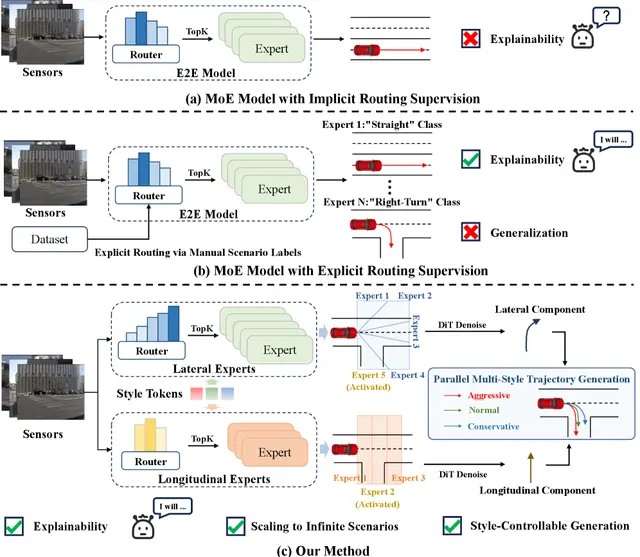
D³-MoE:风格可控的自动驾驶,让你选择激进或谨慎
Robotics6月6日

D³-MoE:风格可控的自动驾驶,让你选择激进或谨慎
一种新的端到端自动驾驶系统,让操作员能够调节特定的驾驶风格——从保守的紧贴车道到激进的变道,无需重新训练模型。

Renju Feng, Rukang Wang, Ning Xi +4

WAM-Nav:基于非对称世界-动作建模的统一视觉导航
Robotics6月6日

WAM-Nav:基于非对称世界-动作建模的统一视觉导航
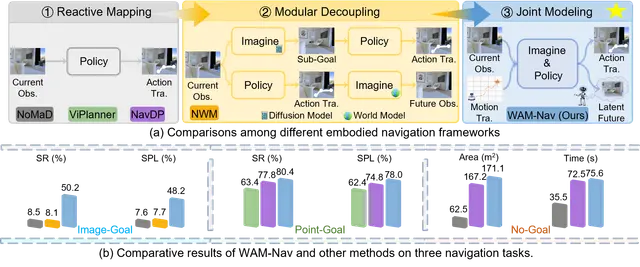
研究人员构建了一个名为WAM-Nav的单一导航模型,可在人形机器人上处理多种目标类型——点、图像、语言。通过联合……

Ning Yang, Yan Huang, Kaiwen Peng +9

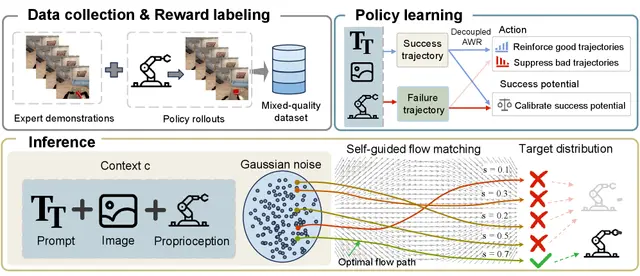
自引导流策略提升机器人任务成功率,无需单独评判网络
Robotics6月6日

自引导流策略提升机器人任务成功率,无需单独评判网络
Yunpeng Mei, Jiakai He, Hongjie Cao +12

自行车骑行者眼动数据揭示更安全的道路基础设施
Robotics6月5日

自行车骑行者眼动数据揭示更安全的道路基础设施

Benjamin Hardin, Efimia Panagiotaki, Daniele De Martini +1

CIPER:统一跨视角检索与位姿估计的机器人定位模型
Robotics6月5日

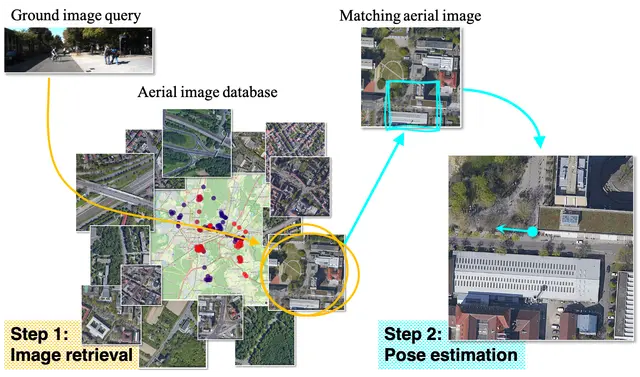
CIPER:统一跨视角检索与位姿估计的机器人定位模型
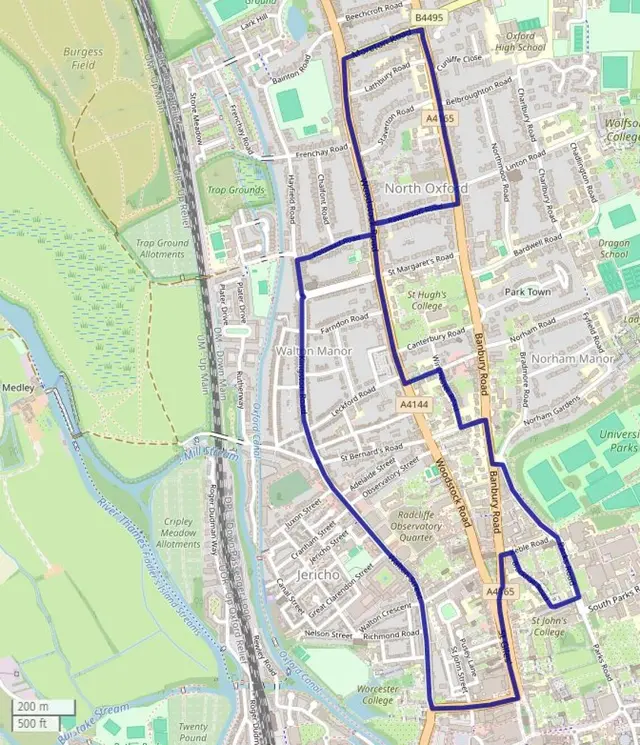
研究人员构建了CIPER,这是一种单一Transformer网络,能够同时从城市级数据库中检索正确的航空图像,并估计地面相机的精确位姿,实现端到端定位。

Yurim Jeon, Dongseong Seo, Seung-Woo Seo

跨环境泛化的四旋翼导航世界模型
Robotics6月5日

跨环境泛化的四旋翼导航世界模型

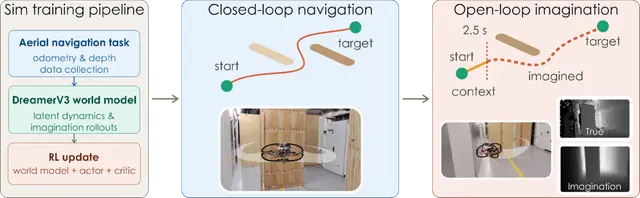
四旋翼导航世界模型实现跨未知环境泛化,支持闭环与短时开环飞行。

Luca Zanatta, Grzegorz Malczyk, Kostas Alexis

HORIZON:一种基于可恢复性的课程学习方法,用于扩展机器人运动中的物理领域
Robotics6月4日

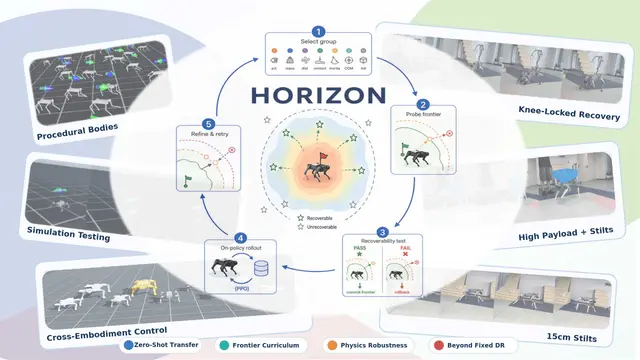
HORIZON:一种基于可恢复性的课程学习方法,用于扩展机器人运动中的物理领域

Chenhao Bai, Liqin Lu, Kaijun Wang +5

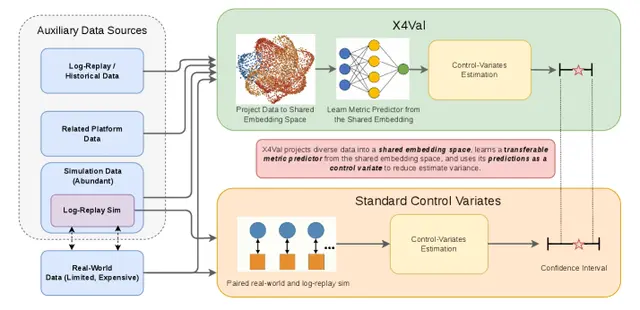
X4Val利用神经代理模型大幅降低机器人验证成本
Robotics6月4日

X4Val利用神经代理模型大幅降低机器人验证成本
Rachel Luo, Michael Watson, Apoorva Sharma +6

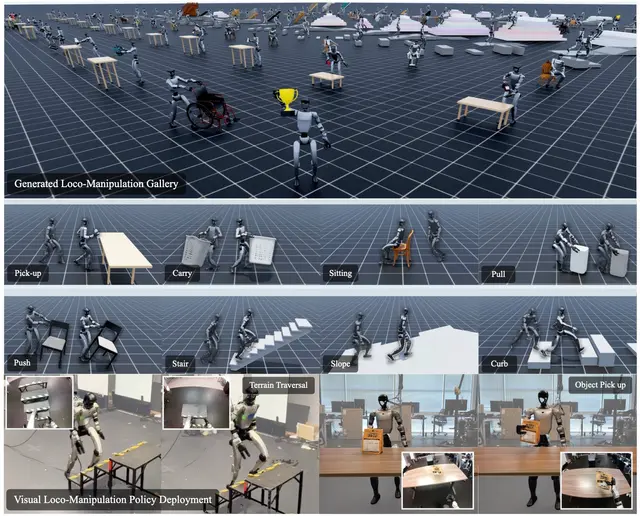
GRAIL Generates Humanoid Loco-Manipulation from 3D Assets and Video Priors
Humanoid6月4日

GRAIL Generates Humanoid Loco-Manipulation from 3D Assets and Video Priors

GRAIL generates over 20,000 humanoid loco-manipulation sequences from 3D assets and video priors, achieving 84% pick-up and 90% stair-climbing success on a Unitree G1.

Tianyi Xie, Haotian Zhang, Jinhyung Park +17

用于动态 VLA 操控的隐空间预测世界模型
Robotics6月3日

用于动态 VLA 操控的隐空间预测世界模型

视觉-语言-动作模型在处理动态物体时存在困难。AHEAD 引入隐空间预测世界模型,结合流匹配、运动学条件化和自适应停止,实现 VLA 操控中移动物体的实时拦截。

Shahram Najam Syed, Arthur Jakobsson, Haoran Hao +1

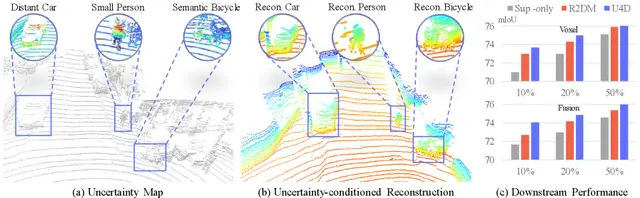
面向更智能自动驾驶的不确定性感知4D LiDAR场景合成
Robotics6月3日

面向更智能自动驾驶的不确定性感知4D LiDAR场景合成
Xiang Xu, Alan Liang, Youquan Liu +5

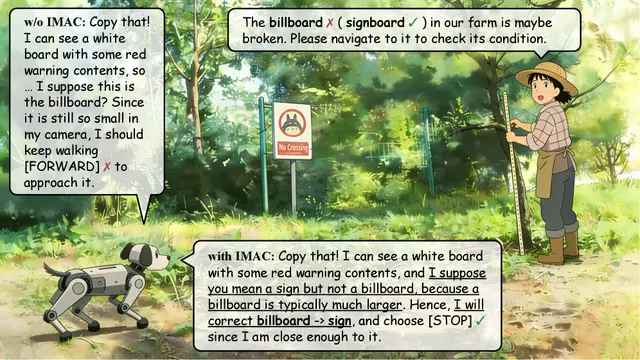
新型农业机器人导航系统:检测并纠正指令错误
Robotics6月3日

新型农业机器人导航系统:检测并纠正指令错误

Xiaobei Zhao, Xingqi Lyu, Xin Chen +1

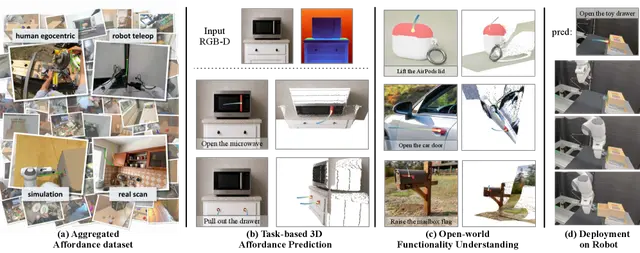
从视觉数据理解物体功能的基础模型
Robotics6月2日

从视觉数据理解物体功能的基础模型

AFUN:一个从视觉数据理解物体功能的功能基础模型,使用MetaQuery tokens和三阶段训练预测功能掩码和运动轨迹。

Zhaoning Wang, Yi Zhong, Jiawei Fu +2

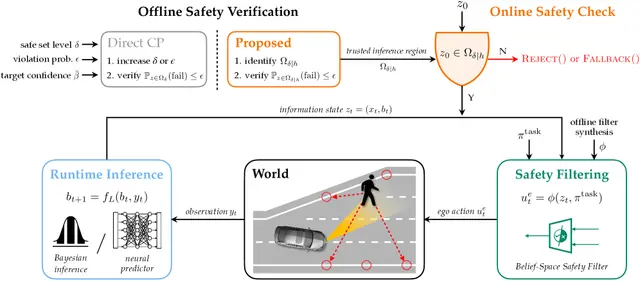
互动机器人新型安全过滤器:利用可信推理避免过度谨慎行为
AI6月2日

互动机器人新型安全过滤器:利用可信推理避免过度谨慎行为

研究人员开发了一种信念空间安全过滤器的验证方法,减少了互动机器人中不必要的保守性。通过聚焦…

Haimin Hu

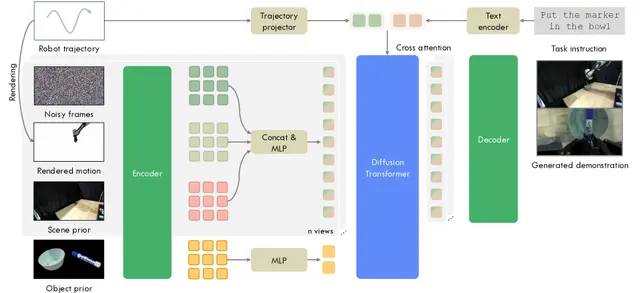
RoboDream:组合世界模型高效提升机器人数据合成
Robotics6月2日

RoboDream:组合世界模型高效提升机器人数据合成

Junjie Ye, Rong Xue, Basile Van Hoorick +6