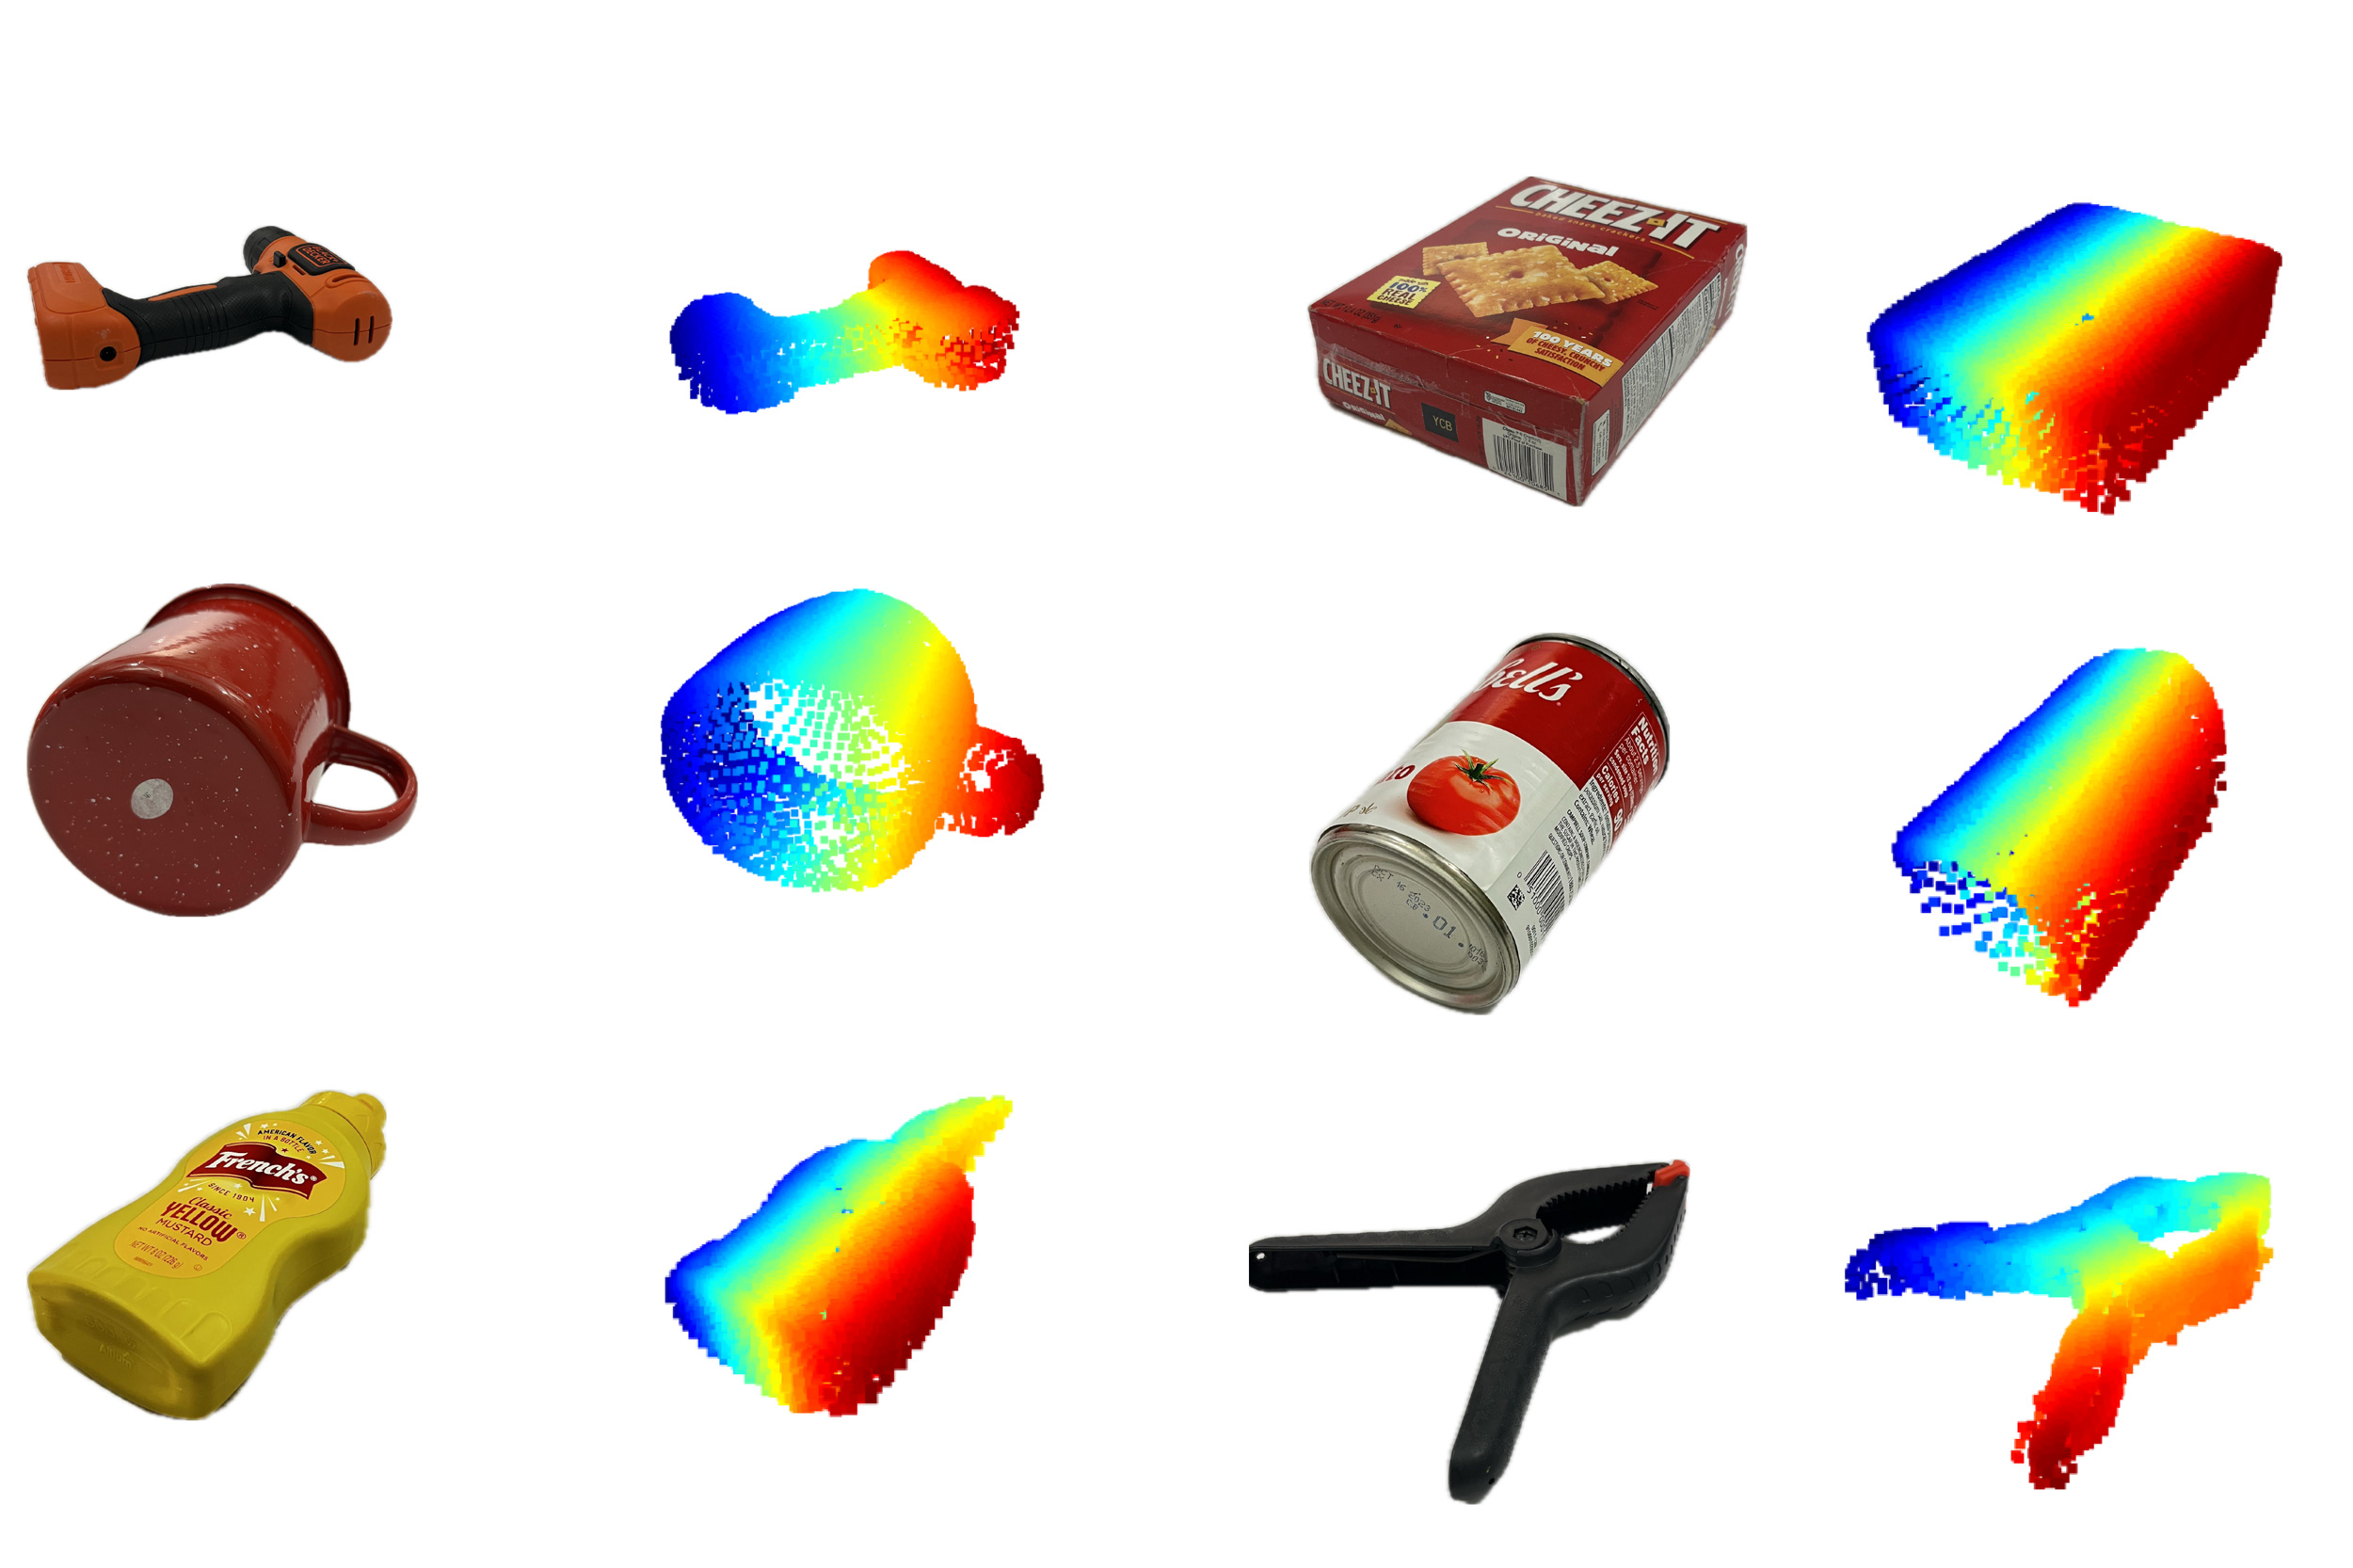
I ricercatori del MIT hanno utilizzato modelli di IA generativa appositamente addestrati per creare un sistema in grado di completare la forma di oggetti 3D nascosti. Credito: per gentile concessione dei ricercatori.
I robot che operano in magazzini e case intelligenti hanno un punto cieco fondamentale: tutto ciò che è nascosto alle loro telecamere semplicemente non esiste per loro. I ricercatori del MIT hanno ora impiegato l'IA generativa per risolvere questo problema, utilizzando segnali wireless a onde millimetriche e modelli di IA appositamente addestrati per ricostruire oggetti nascosti e intere stanze con quasi il 20% di accuratezza in più rispetto ai metodi precedenti, senza una singola telecamera.
- Perché la visione robotica basata su telecamera ha una debolezza strutturale
- Come Wave-Former ricostruisce oggetti nascosti attraverso i muri
- RISE: mappare intere stanze da un singolo radar
- Il problema dei dati di addestramento — e come lo ha risolto il MIT
- Cosa significa per la robotica di magazzino e industriale
- Domande frequenti
Perché la visione robotica basata su telecamera ha una debolezza strutturale
La percezione robotica che dipende dalle telecamere fallisce nel momento in cui un oggetto esce dalla linea di vista — dietro un imballaggio, sotto detriti o oltre un angolo. Non si tratta di un caso limite: è una realtà operativa quotidiana in magazzini, hub logistici e ambienti domestici dove i robot devono localizzare, identificare e afferrare oggetti che non possono vedere direttamente.
Le soluzioni alternative esistenti — telecamere multiple, luce strutturata, LiDAR — condividono tutte lo stesso vincolo: richiedono un percorso ottico libero. Non appena cartone, cartongesso, plastica o persino tessuti densi entrano in gioco, il robot è di fatto cieco. Questa limitazione causa errori costosi nelle operazioni di fulfillment, inclusi articoli imballati in modo errato e prese fallite che bloccano le linee di produzione.
Il gruppo Signal Kinetics del MIT, guidato dal professore associato Fadel Adib, ha trascorso oltre un decennio a sviluppare alternative utilizzando segnali radar a onde millimetriche (mmWave) — la stessa banda di frequenza usata nel Wi-Fi moderno — che attraversano ostacoli comuni e si riflettono su oggetti nascosti. La sfida, fino ad ora, era che quelle riflessioni erano troppo incomplete per essere utili per una manipolazione precisa.
Come Wave-Former ricostruisce oggetti nascosti attraverso i muri
Wave-Former, il nuovo sistema del MIT, combina radar mmWave con un modello di IA generativa per ricostruire la forma 3D completa di oggetti nascosti dietro ostacoli — raggiungendo un miglioramento dell'accuratezza vicino al 20% rispetto ai metodi precedenti all'avanguardia su circa 70 oggetti di uso quotidiano tra cui lattine, scatole, utensili e frutta.
Il problema fisico centrale è la specularità: i segnali mmWave si riflettono sulle superfici in una singola direzione, come la luce su uno specchio. Il sensore radar cattura solo le riflessioni dirette verso di esso, il che significa che la superficie superiore di un oggetto nascosto è parzialmente visibile mentre i lati e la parte inferiore sono di fatto invisibili. I sistemi precedenti tentavano di interpretare queste nuvole di punti incomplete usando solo regole basate sulla fisica — un approccio fondamentalmente limitato.
Il pipeline di Wave-Former funziona in tre fasi. Prima, costruisce una ricostruzione parziale dell'oggetto nascosto dalle riflessioni mmWave grezze. Secondo, alimenta quella forma parziale a un modello di IA generativa addestrato a prevedere completamenti plausibili. Terzo, raffina iterativamente la superficie fino a convergere su una ricostruzione 3D completa. Il risultato: i robot possono non solo rilevare un oggetto nascosto, ma comprenderne la geometria abbastanza bene da pianificare una presa affidabile.
Secondo la copertura di Robohub della ricerca, il sistema è stato validato su oggetti nascosti dietro o sotto cartone, legno, cartongesso, plastica e tessuto — esattamente i materiali presenti in ambienti reali di magazzino e logistica.
RISE: mappare intere stanze da un singolo radar
Il secondo sistema del MIT, RISE (Radar-based Indoor Scene Understanding), ricostruisce la disposizione completa delle stanze — inclusa l'ubicazione dei mobili — utilizzando le riflessioni da un singolo radar mmWave fisso. Raggiunge circa il doppio della precisione spaziale delle tecniche esistenti e non richiede una piattaforma sensore mobile.
La maggior parte degli approcci attuali alla ricostruzione wireless di scene richiede un radar montato su un robot in movimento per scansionare l'ambiente — un vincolo operativo significativo. RISE adotta un approccio diverso: sfrutta le riflessioni multipercorso generate dagli esseri umani che si muovono naturalmente in una stanza.
Quando una persona si muove, i segnali mmWave rimbalzano su di essa, poi si riflettono nuovamente su pareti e mobili prima di tornare al radar. Questi echi secondari — tipicamente scartati come rumore sotto l'etichetta "segnali fantasma" — in realtà codificano informazioni spaziali sulla disposizione della stanza. Mentre la persona si muove, i segnali fantasma si spostano, e le loro posizioni mutevoli rivelano la geometria delle superfici circostanti.
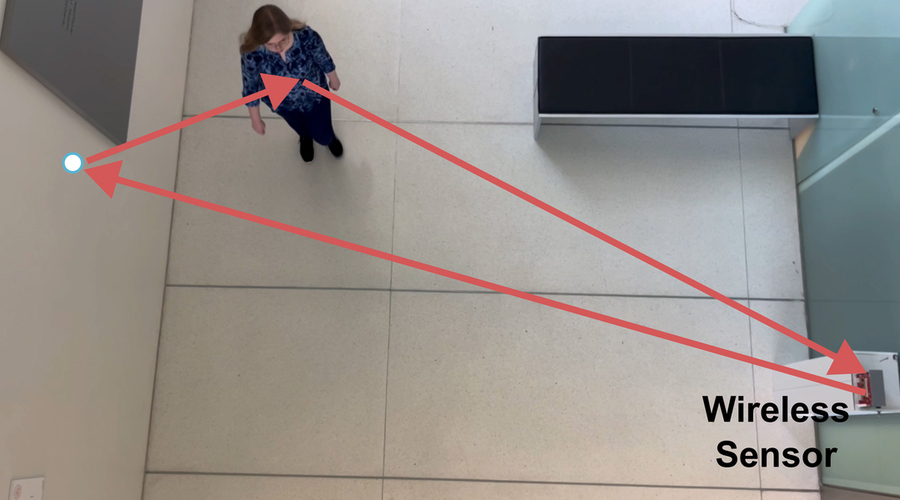 Il team ha anche costruito un sistema esteso che ricostruisce completamente intere scene indoor sfruttando le riflessioni di segnali wireless da esseri umani in movimento in una stanza. Credito: per gentile concessione dei ricercatori.
RISE è stato validato su più di 100 traiettorie umane catturate da un singolo radar fisso. L'implicazione per la privacy è anche notevole: a differenza dei sistemi a telecamera, il radar mmWave non cattura immagini visive delle persone, rendendolo utilizzabile in ambienti dove le telecamere incontrano barriere normative o di consenso.
Il problema dei dati di addestramento — e come lo ha risolto il MIT
L'ostacolo fondamentale per qualsiasi modello di IA in questo settore è la scarsità di dati: nessun dataset mmWave è abbastanza grande da addestrare un modello generativo da zero. La soluzione del MIT è stata simulare la fisica mmWave su dataset di visione artificiale su larga scala esistenti — insegnando di fatto all'IA il linguaggio del radar senza bisogno di dati di addestramento specifici per radar.
Addestrare modelli generativi di grandi dimensioni come GPT o Claude richiede dataset con milioni o miliardi di esempi. I dataset di ricerca mmWave sono di ordini di grandezza più piccoli. Raccogliere dati radar reali sufficienti avrebbe, come spiega Maisy Lam, assistente di ricerca al MIT, "richiesto anni".
La soluzione del team è stata l'adattamento sintetico: hanno preso grandi dataset di visione artificiale esistenti e hanno imposto computazionalmente le proprietà fisiche delle riflessioni mmWave — specularità, caratteristiche di rumore, geometria del segnale — sui dati delle immagini. Questo ha creato un set di addestramento sintetico ma fisicamente accurato da cui il modello generativo poteva imparare.
L'approccio rappresenta un modello più ampio che emerge nella ricerca sull'IA fisica: l'uso di simulazioni informate dalla fisica per avviare l'addestramento dell'IA dove i dati del mondo reale sono scarsi o costosi da raccogliere. Lo stesso principio è alla base di gran parte dei progressi nell'apprendimento della manipolazione robotica, dove il trasferimento sim-to-real è diventato un paradigma dominante.
| Sistema | Compito | Fonte del segnale | Guadagno di accuratezza | Configurazione del sensore |
|---|---|---|---|---|
| Wave-Former | Ricostruzione 3D di oggetti nascosti | Riflessioni mmWave dagli oggetti | ~20% rispetto allo stato dell'arte | Radar mobile o fisso |
| RISE | Ricostruzione completa della scena di una stanza | Riflessioni mmWave da esseri umani in movimento | ~2× precisione rispetto allo stato dell'arte | Singolo radar fisso |
Cosa significa per la robotica di magazzino e industriale
Per acquirenti e ingegneri di robotica, questi due sistemi affrontano problemi operativi diversi ma ugualmente pressanti: verificare gli articoli impacchettati in contenitori sigillati e consentire ai robot di comprendere ambienti dinamici senza una copertura sensoriale completa.
Fulfillment e verifica dei pacchi
I robot di magazzino attualmente non possono conferire cosa c'è dentro una scatola sigillata senza aprirla. La capacità di Wave-Former di ricostruire la geometria 3D degli oggetti attraverso cartone e plastica affronta direttamente la verifica pre-spedizione — un punto critico per il fulfillment dell'e-commerce, dove i tassi di reso dovuti a ordini mal impacchettati generano costi significativi. Un robot dotato di percezione mmWave potrebbe verificare la presenza e la geometria approssimativa degli articoli prima che una scatola venga sigillata, senza rallentare la linea.
Distribuzione intelligente per cobot e AMR
La capacità di mappatura delle stanze con un singolo radar di RISE ha implicazioni immediate per i robot mobili autonomi (AMR) e i cobot distribuiti in spazi condivisi con gli esseri umani. Gli attuali approcci di tracciamento umano richiedono una fitta copertura di telecamere (con associati problemi di privacy) o sensori montati sul robot stesso. Un radar fisso che costruisce un modello spaziale in tempo reale della stanza — incluse le posizioni umane — dall'analisi dei segnali fantasma potrebbe consentire un funzionamento più sicuro e reattivo dei cobot in ambienti dinamici.
Per i team che valutano robot per queste applicazioni, vale la pena esplorare robot industriali usati e cobot attualmente disponibili su Robot Overflow mentre monitorano come sistemi di percezione come Wave-Former progrediscono verso l'integrazione commerciale.
Tempistiche per la distribuzione
Entrambi i sistemi sono in fase di ricerca, con risultati da presentare alla IEEE Conference on Computer Vision and Pattern Recognition. La ricerca è supportata da NSF, MIT Media Lab e Amazon — quest'ultimo è un segnale significativo di interesse commerciale. Il prossimo obiettivo dichiarato del team è costruire modelli foundation per segnali wireless, analoghi a GPT o Gemini per il linguaggio, che rappresenterebbero un cambiamento radicale nella generalizzabilità di questo approccio attraverso ambienti e tipi di oggetti.
Domande frequenti
Cos'è Wave-Former e come funziona?
Wave-Former è un sistema sviluppato dal MIT che utilizza segnali radar a onde millimetriche (mmWave) per ricostruire la forma 3D di oggetti nascosti dietro ostacoli come cartone, cartongesso e plastica. Costruisce una ricostruzione parziale dalle riflessioni radar, quindi utilizza un modello di IA generativa per completare la geometria mancante. Nei test su circa 70 oggetti di uso quotidiano, ha raggiunto quasi il 20% di accuratezza in più rispetto ai metodi precedenti all'avanguardia.
Come fa RISE a ricostruire stanze senza telecamere?
RISE utilizza un singolo radar mmWave fisso e sfrutta i "segnali fantasma" — riflessioni secondarie che rimbalzano sugli esseri umani che si muovono in una stanza e poi su mobili e pareti circostanti. Tracciando come queste riflessioni multipercorso cambiano mentre la persona si muove, un modello di IA generativa deduce la disposizione spaziale dell'intera stanza. RISE ha dimostrato circa il doppio della precisione spaziale delle tecniche esistenti di ricostruzione wireless di scene su più di 100 traiettorie di test.
Quali ostacoli possono penetrare i segnali mmWave?
I segnali a onde millimetriche — la stessa gamma di frequenza usata nel Wi-Fi — attraversano materiali non metallici comuni tra cui cartone, legno, cartongesso, plastica e tessuto. Non penetrano efficacemente il metallo. Questo li rende adatti per ambienti di magazzino dove le merci sono imballate in cartone e plastica, ma meno applicabili in recinti industriali fortemente metallici.
Questa tecnologia preserva la privacy meglio delle telecamere?
Sì. Il radar mmWave non cattura immagini visive delle persone nell'ambiente — rileva solo riflessioni di segnale. La capacità di mappatura delle stanze di RISE utilizza il movimento umano come fonte di segnale senza registrare dati visivi identificabili, il che gli conferisce un vantaggio significativo rispetto alla mappatura spaziale basata su telecamera in implementazioni sensibili alla privacy come ospedali, case o luoghi di lavoro regolamentati.
Quando sarà disponibile questa tecnologia nei robot commerciali?
Sia Wave-Former che RISE sono attualmente in fase di ricerca, con articoli da presentare al CVPR. Amazon è tra i partner di finanziamento, suggerendo un interesse commerciale attivo. Il team del MIT ha indicato che la costruzione di modelli foundation per segnali wireless è la prossima priorità di sviluppo. L'integrazione commerciale in sistemi di magazzino o cobot è probabilmente a anni di distanza, ma la traiettoria verso hardware distribuibile è chiara.
Questa ricerca rappresenta uno dei progressi più concretamente fondati nella percezione robotica dell'ultimo anno — non un miglioramento marginale dei benchmark, ma un vero cambiamento architetturale nel modo in cui i robot possono modellare il mondo che li circonda. L'IA generativa non è più solo uno strumento per linguaggio o immagini; sta diventando il motore di inferenza che consente ai sistemi fisici di ragionare su ciò che non possono osservare direttamente.