
Este trabajo analiza dos enfoques diferentes para diseñar una cadena de procesamiento integral capaz de procesar entradas RGB-D y proporcionar a una lógica de control un mapa de affordances. La tarea se apoya en una circuitería compacta conectada a un sensor e integrada en una plataforma portátil. En ambos casos, el principal desafío consiste en desarrollar una cadena de procesamiento integral que cumpla los requisitos de precisión y funcione en un dispositivo embebido sujeto a restricciones de consumo energético y operación en tiempo real.
Búsqueda de arquitecturas neuronales consciente del hardware
La HW-NAS suele orientar el diseño de modelos DNN compactos y eficientes desde el punto de vista del hardware, ya que permite adaptar las arquitecturas de red a las plataformas de destino. Al emplear HW-NAS, es necesario definir un espacio de búsqueda, un criterio de selección y una estrategia de exploración.
El espacio de búsqueda abarca el conjunto de redes candidatas admisibles. Diversos estudios han demostrado que el diseño de este espacio resulta crucial para el rendimiento final. Ya se han establecido varios espacios de búsqueda populares y de propósito general.
Diseño de sistemas portátiles eficientes de detección basados en DNN para datos RGB-D
Se consideran dos enfoques diferentes para diseñar una cadena de procesamiento integral capaz de procesar entradas RGB-D y proporcionar a una lógica de control un mapa de affordances. La tarea se apoya en una circuitería compacta conectada a un sensor e integrada en una plataforma portátil.
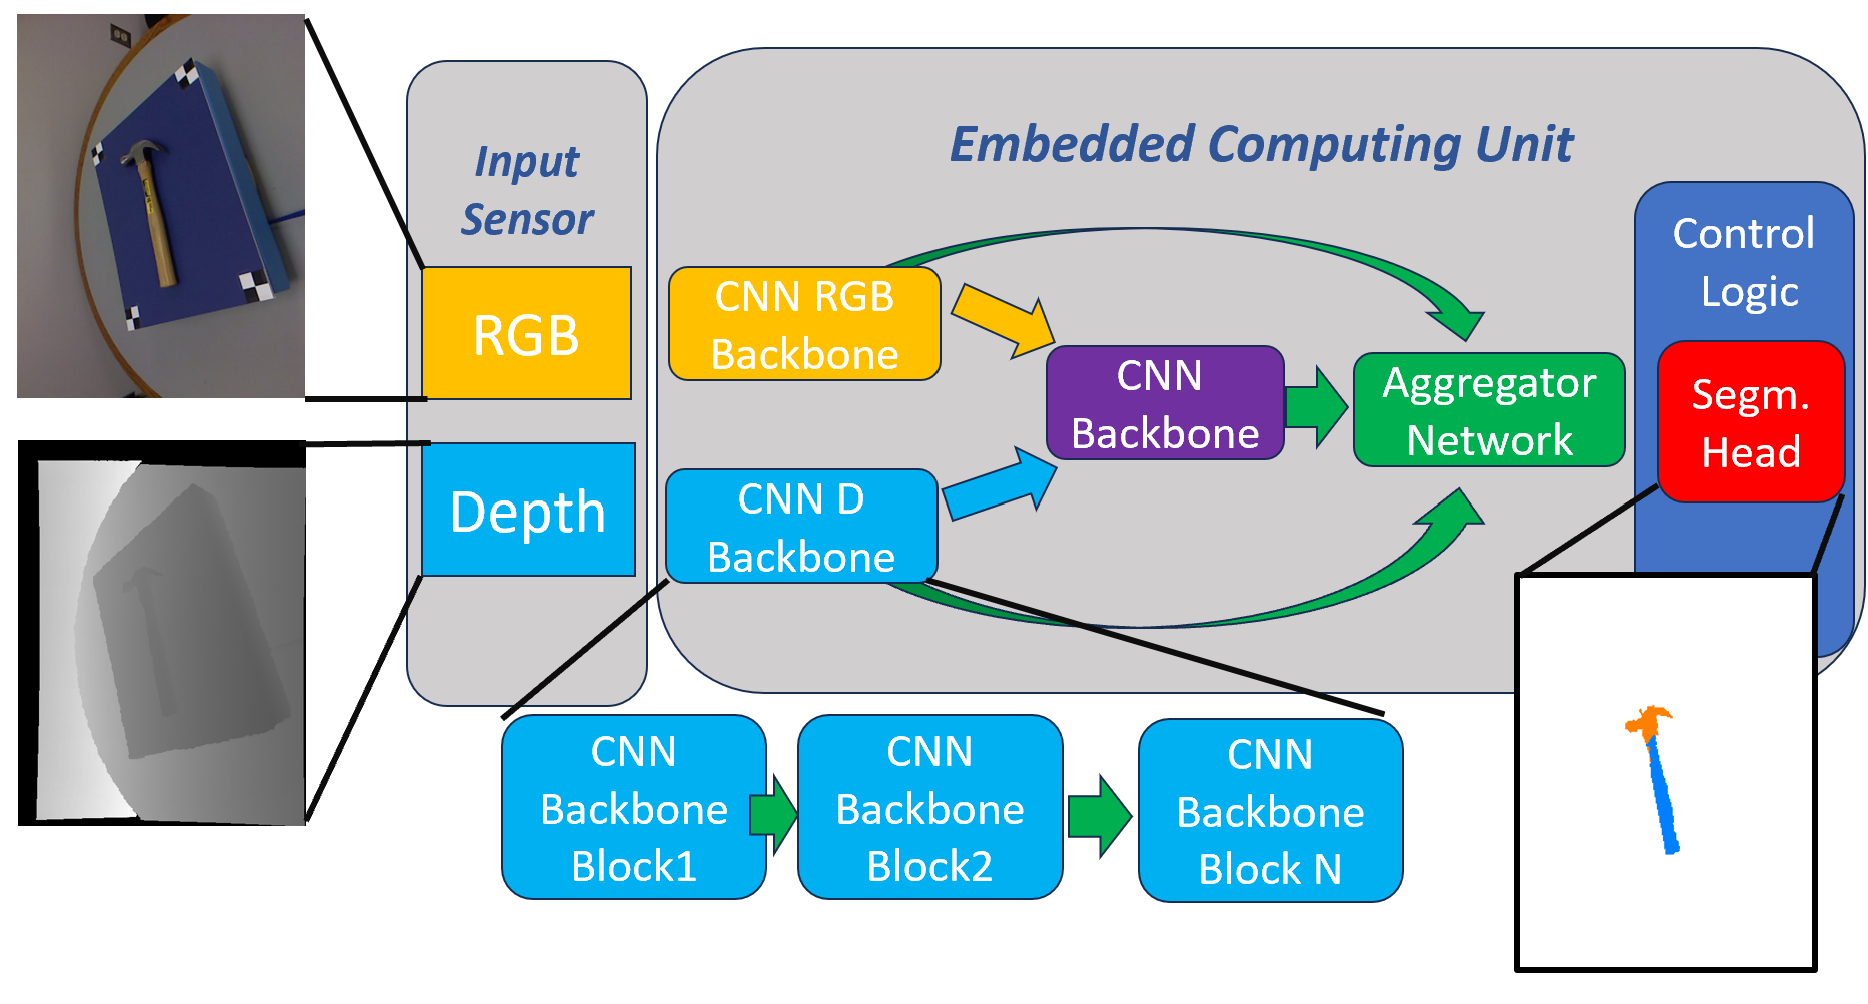
En ambos casos, el principal desafío consiste en desarrollar una cadena de procesamiento integral que a) cumpla los requisitos de precisión y b) funcione en un dispositivo embebido sujeto a restricciones de consumo energético y operación en tiempo real.
Enfoque basado en fine-tuning
La HW-NAS puede presentar algunos inconvenientes. En primer lugar, puede implicar costes computacionales considerables durante el entrenamiento. En segundo lugar, requiere grandes conjuntos de datos etiquetados, lo que puede limitar su aplicabilidad, ya que obtener máscaras etiquetadas para la segmentación de affordances puede consumir mucho tiempo. Por último, la definición de affordance puede variar según el contexto y exigir potencialmente volver a entrenar la red.
Por ello, se plantea una estrategia de diseño alternativa que no utiliza HW-NAS. El objetivo principal es aplicar un proceso de fine-tuning para incorporar información de profundidad a una arquitectura preentrenada y altamente optimizada para entradas RGB.
La capa adicional se integra en la arquitectura y sus valores de filtro se aprenden mediante retropropagación convencional. Esto permite optimizar la correspondencia de entrada y, al mismo tiempo, conservar la configuración de pesos preexistente. Podría argumentarse que modificar la capa base de una red profunda compromete el fine-tuning, dado que el reentrenamiento suele afectar a las capas superiores. Sin embargo, los mapas de profundidad comparten numerosas similitudes estructurales con los datos RGB: es probable que las características optimizadas para imágenes RGB también funcionen bien con datos de profundidad. Así, el proceso de optimización puede ajustar las características de bajo nivel e incorporar información de profundidad sin alterar significativamente la configuración original de la red.
Configuración experimental
El código se desarrolló en Python utilizando las bibliotecas TensorFlow y Keras. Los benchmarks se obtuvieron a partir de dos conjuntos de datos conocidos: UMD e IIT. El conjunto de datos de la University of Maryland (UMD) incluye 28.843 imágenes RGB-D pertenecientes a 7 categorías de objetos, con múltiples ángulos de encuadre para cada objeto, lo que permite evaluar la capacidad de los modelos para gestionar variaciones en el encuadre.
El conjunto de datos del Italian Institute of Technology (IIT) incluye 8.835 imágenes con variaciones en el encuadre, las condiciones de iluminación, el nivel de oclusión y la resolución. Cada conjunto presenta objetos distintos y se utiliza como benchmark independiente.
Los conjuntos de validación se crearon a partir del conjunto de entrenamiento mediante el método estándar de partición holdout, y los patrones de prueba nunca se utilizaron para ajustar parámetros o hiperparámetros.
En el enfoque basado en fine-tuning se adoptó MobileNetV3 como backbone. MobileNetV3 requiere relativamente pocos recursos computacionales y mantiene un rendimiento satisfactorio en tareas estándar de visión por computador, como la clasificación en ImageNet. El checkpoint del modelo, preentrenado con el conjunto de datos ImageNet, se descargó del repositorio de aplicaciones de Keras. La misma cabeza de segmentación descrita en el trabajo original se incorporó a la arquitectura. En el fine-tuning también se aplicaron los ajustes utilizados para la arquitectura final seleccionada mediante NAS.
Los requisitos de hardware de la red se estimaron utilizando el número de parámetros y los FLOPS. Estas medidas proporcionan una estimación independiente de los dispositivos de destino. Sin embargo, las mediciones específicas de cada plataforma, basadas en hardware en el circuito, pueden mostrar tendencias diferentes según el SDK utilizado.
Uso eficiente de la información de profundidad
La capacidad del enfoque propuesto para utilizar eficazmente la información de profundidad se evalúa analizando tanto el rendimiento de generalización como los requisitos de hardware. La Figura 2 muestra el rendimiento de generalización obtenido con ambos enfoques en el conjunto de datos UMD en función del uso de datos de profundidad. En los dos casos, el gráfico de radar muestra la precisión obtenida para las tres clases y la puntuación media de clasificación; se compara la cadena de procesamiento integral alimentada con datos RGB-D con la alimentada únicamente con datos RGB.

En el enfoque basado en HW-NAS, para los experimentos sin profundidad se simplificó el espacio de búsqueda eliminando el backbone de profundidad. La disponibilidad de información de profundidad aumentó la precisión en todas las clases. Las mejoras fueron más acusadas en las clases 'Grasp' y 'Don't Grasp', con incrementos del 2,8 % en cada una; por lo general, son las clases más difíciles.
En el enfoque basado en fine-tuning, la red que utiliza datos de profundidad supera a la línea base en las clases 'Grasp' y 'Don't Grasp' en un 2,6 % y un 3,6 %, respectivamente. En la clase 'Background' se observa un deterioro insignificante del 0,3 %, que podría atribuirse a fluctuaciones estadísticas del proceso de optimización. Ambas pruebas confirmaron el beneficio de la información de profundidad para mejorar el rendimiento de generalización del modelo.
Impacto del tamaño de entrada en el rendimiento
Los FLOPS siguen siendo el mejor estimador independiente del dispositivo para el tiempo de inferencia. La fiabilidad de esta estimación aumenta a medida que disminuye el número de núcleos de la unidad de cómputo. Por ejemplo, en microcontroladores, la correlación entre los FLOPS y el tiempo de inferencia se aproxima a 1.
Análisis de las salidas
El impacto real de los sensores de profundidad en la segmentación de affordances puede variar considerablemente según el objeto. Se llevó a cabo un análisis con un conjunto de prueba generado mediante Unreal Engine 5. Esta configuración permitió crear numerosas imágenes heterogéneas mediante un procedimiento económico, en el que el simulador generó patrones de prueba compuestos por imágenes RGB-D y máscaras de affordances.
Se creó un conjunto de prueba de 2.000 imágenes con objetos pertenecientes a las mismas clases disponibles en el conjunto de datos UMD. A continuación, los modelos entrenados con UMD se probaron con este conjunto, y se observó una mejora del 11,5 % en la precisión media al utilizar información de profundidad. Esta diferencia se redujo al 4,6 % al aplicar aumento de datos para mitigar los problemas entre dominios que suelen asociarse a las imágenes generadas por simuladores. Los resultados confirmaron la ventaja de utilizar datos de profundidad para generalizar a objetos de prueba no vistos, gracias a la información geométrica que proporcionan.
Despliegue en aceleradores embebidos
Los dos modelos propuestos que utilizan datos RGB-D se desplegaron en un prototipo compuesto por un Jetson Nano conectado a una cámara RGB-D RealSense, una de las cámaras RGB-D más utilizadas. El Jetson Nano se eligió entre los aceleradores embebidos disponibles por ofrecer un excelente equilibrio entre rendimiento y consumo energético.
La comparación incluyó cuatro modelos: las implementaciones básicas de TensorFlow de NAS RGBD y Mob3 RGBD, y sus versiones optimizadas (_opt), obtenidas mediante el optimizador TRT con cuantización float16.
Todos los datos de latencia y uso de memoria se obtuvieron realizando 100 inferencias sobre imágenes RGB-D capturadas por la cámara. Salvo que se indique explícitamente lo contrario, las métricas presentadas corresponden a valores medios. El uso de memoria se supervisó mediante las utilidades del sistema operativo. El consumo energético se midió registrando la corriente extraída en la entrada de alimentación de la placa mediante un vatímetro. Las condiciones de encuadre no fueron especialmente relevantes para los requisitos de hardware, ya que estos son independientes de la imagen de entrada.
El primer análisis evalúa el tiempo de inferencia de los modelos con dos configuraciones de potencia del Jetson Nano: 5 W y 10 W. En ambos casos, el valor corresponde al consumo máximo de potencia estimado. La tabla muestra, para cada modelo probado, el tiempo necesario para procesar un fotograma y la tasa de fotogramas expresada en fotogramas por segundo.
Los resultados muestran que la optimización tuvo un impacto significativo en el tiempo de inferencia de ambos modelos. Las dos versiones optimizadas permiten realizar inferencias en menos de 120 ms, lo que posibilita un procesamiento relativamente rápido y adecuado para operaciones en tiempo real destinadas a usuarios humanos.
Conclusión
El artículo analizó dos estrategias de diseño diferentes para desplegar la segmentación de affordances en sistemas portátiles de detección. Los resultados demostraron que incluir sensores RGB-D en la cadena de detección permite mejorar el rendimiento de generalización frente a una configuración basada únicamente en cámaras RGB. Un análisis experimental exhaustivo sobre dos benchmarks reales ampliamente conocidos demostró que las estrategias propuestas pueden generar arquitecturas situadas en la frontera de Pareto en términos de rendimiento de generalización y requisitos de hardware. Las arquitecturas generadas mediante estas estrategias pueden procesar imágenes en tiempo real con un consumo energético aceptable al ejecutarse en un prototipo basado en un Jetson Nano y una cámara RGB-D RealSense.
La versión actual del sistema se ha evaluado utilizando imágenes con el objeto en primer plano, dejando en manos de los usuarios el encuadre correcto, lo que podría resultar complicado. Las versiones futuras incorporarán capacidades de localización de objetos para simplificar el encuadre. Además, próximos experimentos aplicarán las mismas técnicas a modelos transformer mediante el diseño de espacios de búsqueda específicos o la adaptación del enfoque de fine-tuning a modelos con codificación posicional. También serán necesarios ensayos clínicos para confirmar los beneficios percibidos por los usuarios en la cadena semiautónoma, en la que el sistema propuesto se integrará en la cadena de control completa. Esto permitirá analizar en profundidad cómo una segmentación eficiente de affordances puede mejorar la interacción del usuario.
Preguntas frecuentes
¿Cuáles son las dos estrategias de diseño principales que se exploran en este artículo para la segmentación de affordances RGB-D? El artículo explora la búsqueda de arquitecturas neuronales consciente del hardware (HW-NAS) y un enfoque basado en fine-tuning que adapta un modelo RGB preentrenado para incorporar información de profundidad mediante una capa de entrada aprendida.
¿Cuánto mejora la precisión por clase gracias a la información de profundidad? La información de profundidad mejoró la precisión de las clases 'Grasp' y 'Don't Grasp' hasta en un 2,8 % con HW-NAS y entre un 2,6 % y un 3,6 % con el enfoque de fine-tuning, mientras que la precisión de 'Background' permaneció prácticamente sin cambios.
¿Pueden los modelos propuestos funcionar en tiempo real con hardware embebido? Sí. Ambos modelos optimizados lograron tiempos de inferencia inferiores a 120 ms en un Jetson Nano conectado a una cámara RGB-D RealSense, lo que permite operar en tiempo real para usuarios humanos.
¿Qué líneas de trabajo futuras se han previsto para este sistema? El trabajo futuro incorporará localización de objetos para simplificar el encuadre, extenderá las técnicas a modelos transformer y realizará ensayos clínicos para evaluar los beneficios para los usuarios dentro de una cadena de control semiautónoma completa.