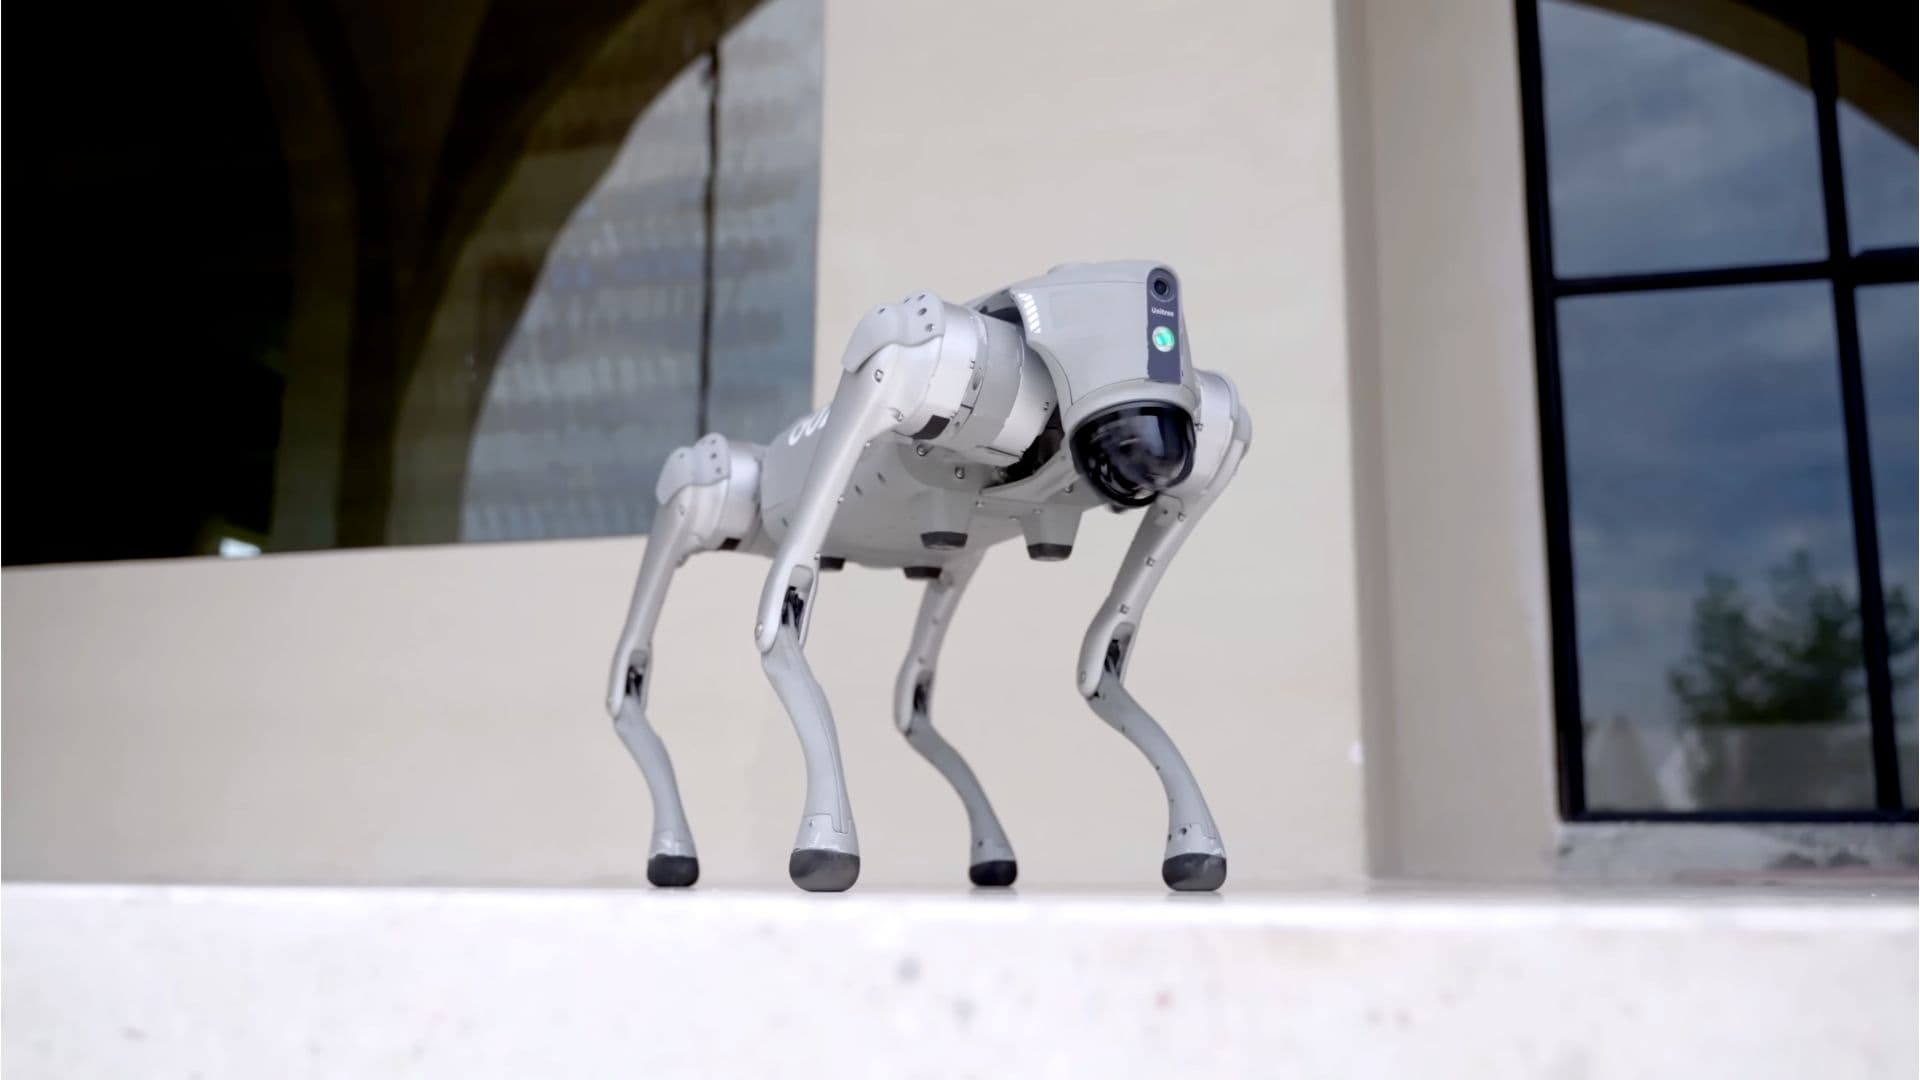
Investigadores entrenaron una política para un cuadrúpedo capaz de realizar 22 tareas con la ayuda de ocho docentes, en un estudio difundido inicialmente en Arxiv. El repertorio incluye habilidades como caminar, excavar y dar saltos, que el método puede combinar para generar comportamientos novedosos, como gatear. La política resultante se implementó en un cuadrúpedo Unitree B1.
El proceso comienza con varias políticas docentes, cada una entrenada mediante aprendizaje por refuerzo para una tarea definida de forma precisa. En las dos etapas siguientes, la destilación con múltiples docentes utiliza esas políticas para entrenar una política estudiante, con un objetivo que combina aprendizaje por refuerzo y aprendizaje por imitación. La selección adversaria de tareas dirige el entrenamiento hacia la tarea con peor rendimiento.
El aprendizaje por refuerzo ha permitido que los robots con patas dominen diversas habilidades en entornos de tarea única, pero aplicaciones como la robótica agrícola y la exploración espacial requieren capacidades variadas. Entre ellas se cuentan la locomoción, la excavación y la inspección a corta distancia. La ineficiencia en el uso de muestras y los conflictos entre gradientes de distintas tareas dificultan el entrenamiento multitarea de extremo a extremo.
Las evaluaciones mostraron que el método mantuvo la calidad del movimiento y siguió las órdenes con más precisión que PPO y que los métodos de referencia de destilación seguida de ajuste fino. En algunos casos, la política estudiante pudo generalizar a tareas nuevas sin entrenamiento explícito.
El método reúne un amplio repertorio de tareas en una sola política estudiante, mientras cada política docente se entrena para una tarea definida de forma precisa. La política resultante se implementó en un cuadrúpedo Unitree B1 para demostrar su robustez en el mundo real.