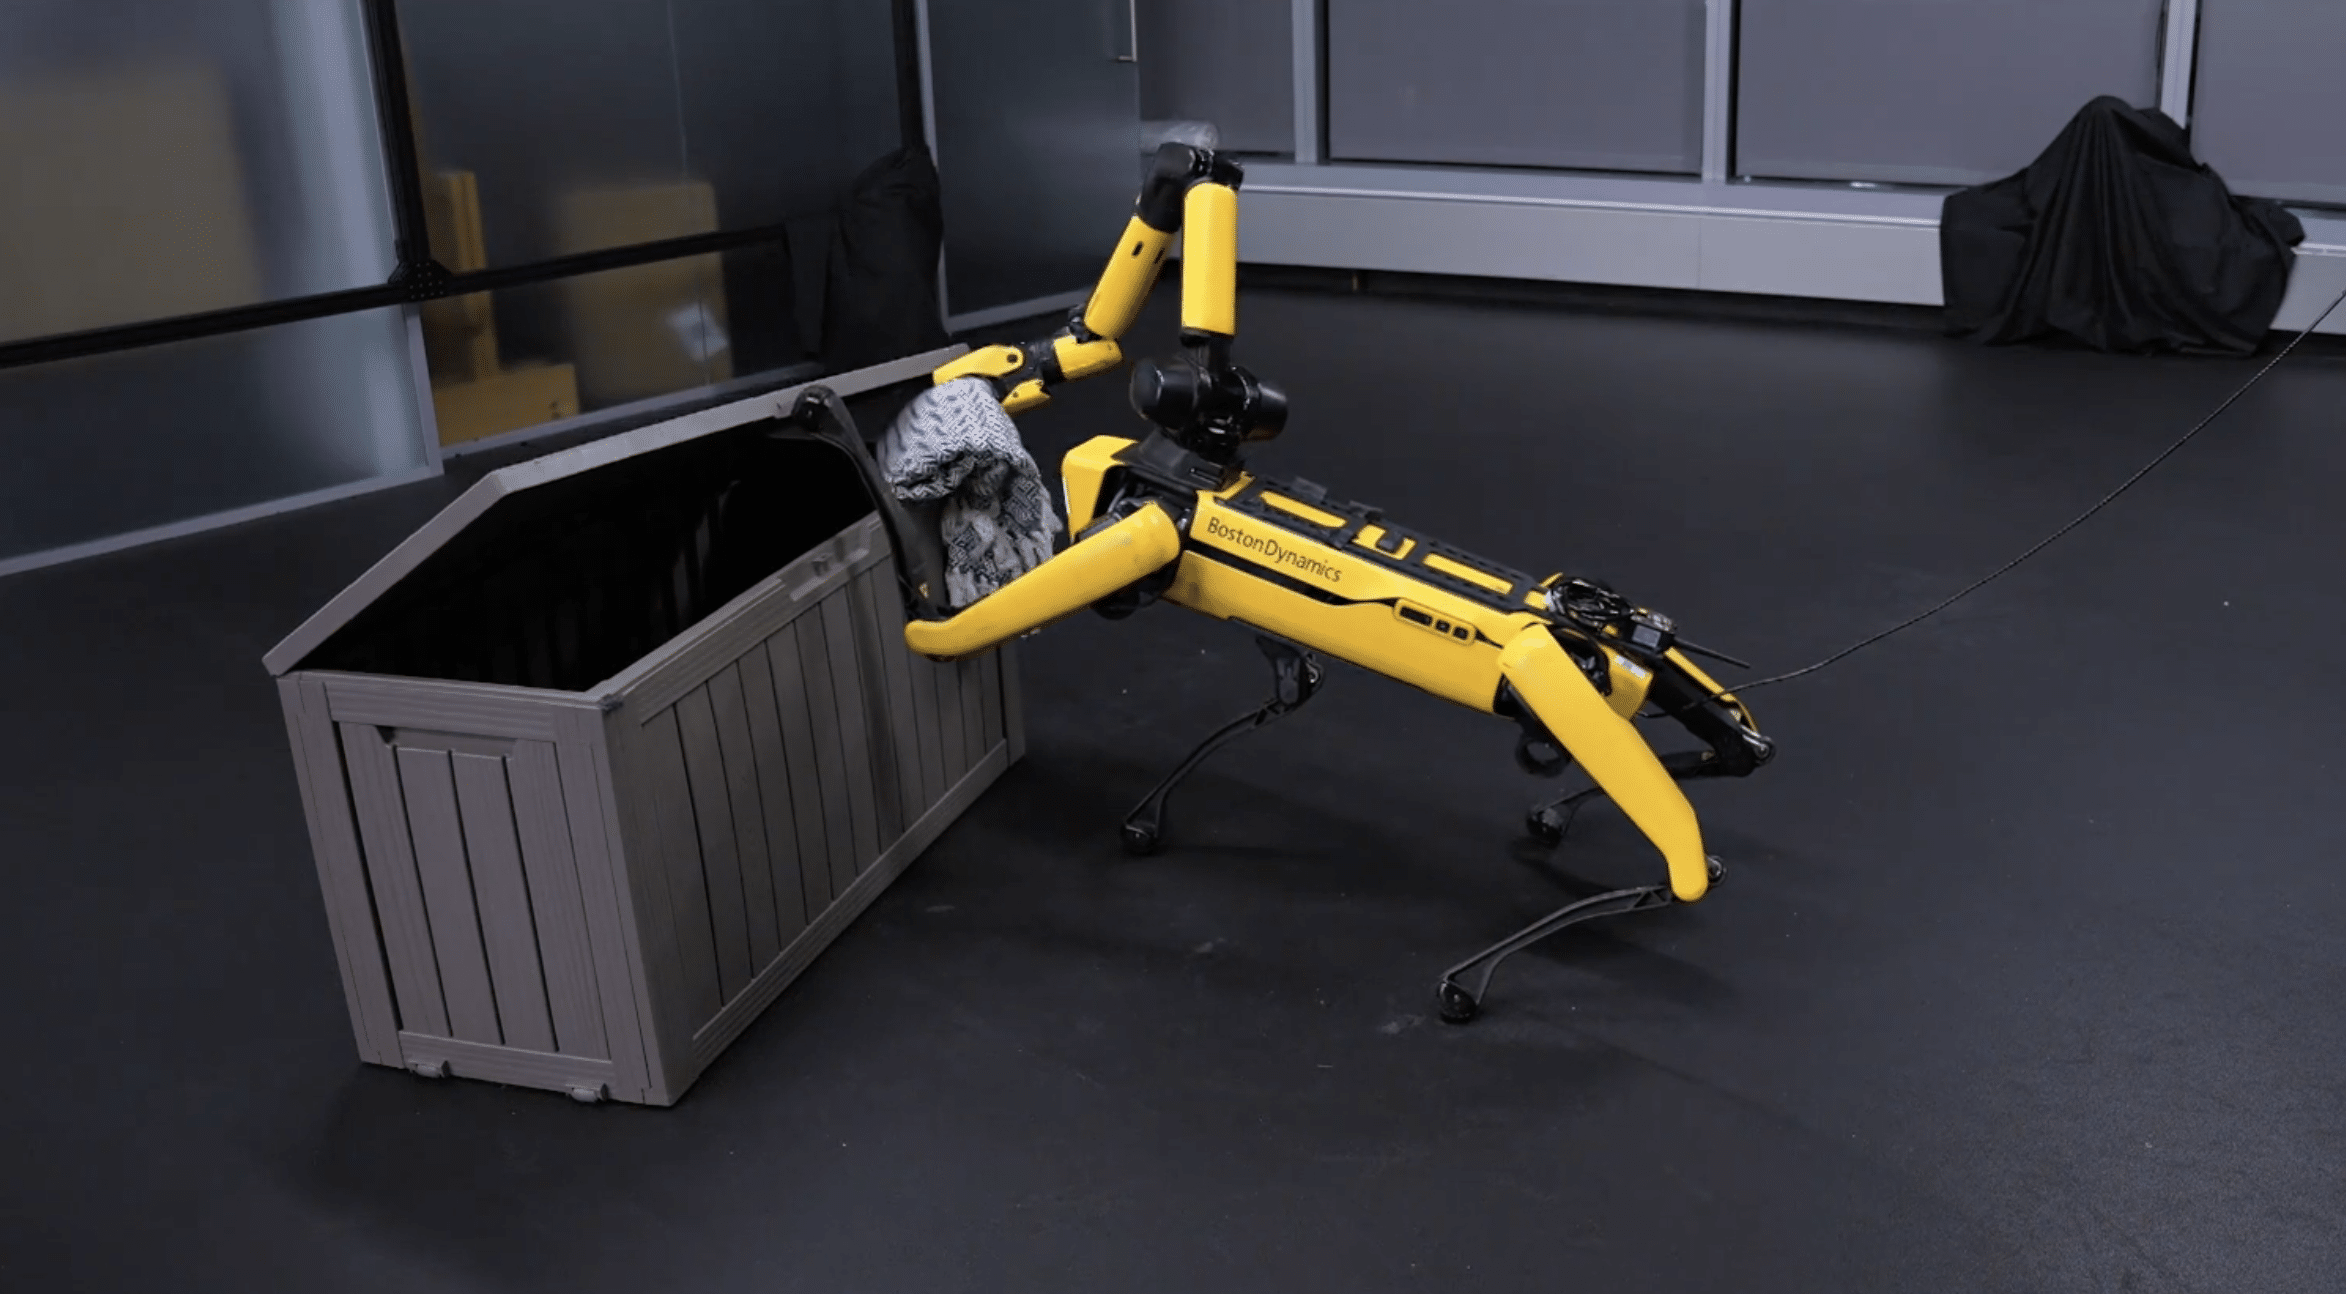
PolyMorphWBC coordina el brazo y la base de un cuadrúpedo mediante trayectorias del efector final para realizar manipulación de alcance ampliado con cuatro familias de brazos montados de 6-DoF, según se informó inicialmente en Arxiv. El controlador debe decidir cómo se reparten el movimiento la base y el brazo, una decisión que depende de la morfología del brazo montado; puede ejecutar trayectorias de manipulación de horizonte corto que superan el alcance inicial con base fija.
La entrada a nivel de tarea es una trayectoria de horizonte corto del efector final (EE), que especifica el movimiento de manipulación deseado sin indicar cómo deben realizarlo el brazo y la base móvil. Un coordinador condicionado por la trayectoria utiliza objetivos EE previstos para determinar el movimiento de la base; la cinemática inversa (IK) específica de cada brazo sigue el objetivo actual, y un backend de locomoción congelado ejecuta el movimiento resultante.
PolyMorphWBC utiliza un condicionamiento morfológico derivado del Formato Unificado de Descripción de Robots (URDF), junto con realimentación en línea de las fuerzas y los momentos residuales, para permitir la reutilización entre brazos. Se entrenó con brazos generados mediante procedimientos y trayectorias estructuradas, tanto dentro como más allá del alcance con base fija.
En IsaacLab, alcanzó una tasa de finalización del 93.95% en trayectorias y morfologías de brazo reservadas para las pruebas, con un error de posición de 2.30cm y un error de orientación de 4.81°. En las evaluaciones de MuJoCo frente a UMI-on-Legs, redujo el error de posición del efector final en un 69–72% y el error de orientación en un 91–97% en cuatro trayectorias dentro del alcance fijo y de alcance ampliado.
Los resultados combinan mediciones del error de trayectoria con una demostración física de recogida y colocación. En un sistema físico Go2–ARX5, PolyMorphWBC demostró tareas de recogida y colocación de alcance ampliado condicionadas por lenguaje, utilizando trayectorias EE de pi_0, sin órdenes para la base generadas por un modelo de visión-lenguaje-acción (VLA).