Enseñar a los robots nuevas habilidades de manipulación suele requerir cientos de horas de datos específicos de la tarea. Un nuevo marco de trabajo demuestra que los robots pueden aprender funciones de recompensa reutilizables a partir de tan solo cinco demostraciones y generalizarlas a posiciones, objetos y perspectivas completamente nuevas sin necesidad de reentrenamiento. Este avance podría acelerar drásticamente el despliegue de robots en fábricas y almacenes al eliminar un cuello de botella importante en el aprendizaje por refuerzo para robótica.
- ¿Por qué fallan las funciones de recompensa en el mundo real?
- ¿Cómo funciona el marco de recompensas invariantes?
- ¿Qué resultados mostraron los experimentos?
- ¿Cómo acelera esto el aprendizaje de políticas posteriores?
- ¿Qué significa la generalización zero-shot para la robótica?
- Implicaciones para la robótica
- Preguntas frecuentes
¿Por qué fallan las funciones de recompensa en el mundo real?
Las funciones de recompensa definen lo que un robot debe lograr en el aprendizaje por refuerzo, pero las recompensas tradicionales basadas en visión memorizan patrones de píxeles específicos en lugar del objetivo subyacente de la tarea. Cuando el ángulo de la cámara cambia, el objeto varía o la iluminación es diferente, estas recompensas fallan, obligando a los ingenieros a rediseñarlas manualmente para cada entorno.
Según los investigadores en su preprint en arXiv, "los modelos de recompensa basados en visión recientes tienden a memorizar distribuciones de píxeles específicas y no logran generalizar más allá de sus condiciones de entrenamiento". Este sobreajuste es un desafío fundamental en problemas de manipulación en entornos abiertos, donde una sola tarea puede aparecer en numerosas variantes con diferentes objetos, posiciones y perspectivas de cámara. Una recompensa entrenada para reconocer una taza roja sobre una mesa blanca falla cuando la taza es azul, la mesa de madera o el robot se acerca desde el lado opuesto. El costo de esta fragilidad es alto: cada nuevo entorno de despliegue requiere efectivamente un nuevo ciclo de ingeniería de recompensas, limitando la escalabilidad.
¿Cómo funciona el marco de recompensas invariantes?
El marco cambia de ajustar características visuales a descubrir invariantes de comportamiento: propiedades a nivel de tarea que permanecen constantes a través de diversas instancias visuales. Utiliza dos componentes acoplados: una formulación estructural de recompensa que codifica estrategias de tarea y restricciones físicas preservando la invariancia de la política óptima, y un procedimiento híbrido simbólico-numérico que extrae estos invariantes de las demostraciones sin ninguna interacción en línea.
Piense en ello como enseñarle al robot la lógica del rompecabezas en lugar de los colores específicos de las piezas; entonces puede resolver cualquier variación. A diferencia de los modelos de recompensa neuronales de extremo a extremo que aprenden correlaciones entre píxeles y éxito, este enfoque busca explícitamente reglas simbólicas que se mantengan a través de transformaciones visuales. El procedimiento híbrido primero extrae predicados simbólicos candidatos de las demostraciones y luego los valida contra restricciones de consistencia física. El resultado es una función de recompensa expresada en términos de relaciones entre objetos y geometría, no de características de imagen crudas. Donde la analogía se rompe es que el marco retiene componentes numéricos para un control fino; no es puramente simbólico, sino que usa símbolos para guiar el cálculo numérico de la recompensa.
¿Qué resultados mostraron los experimentos?
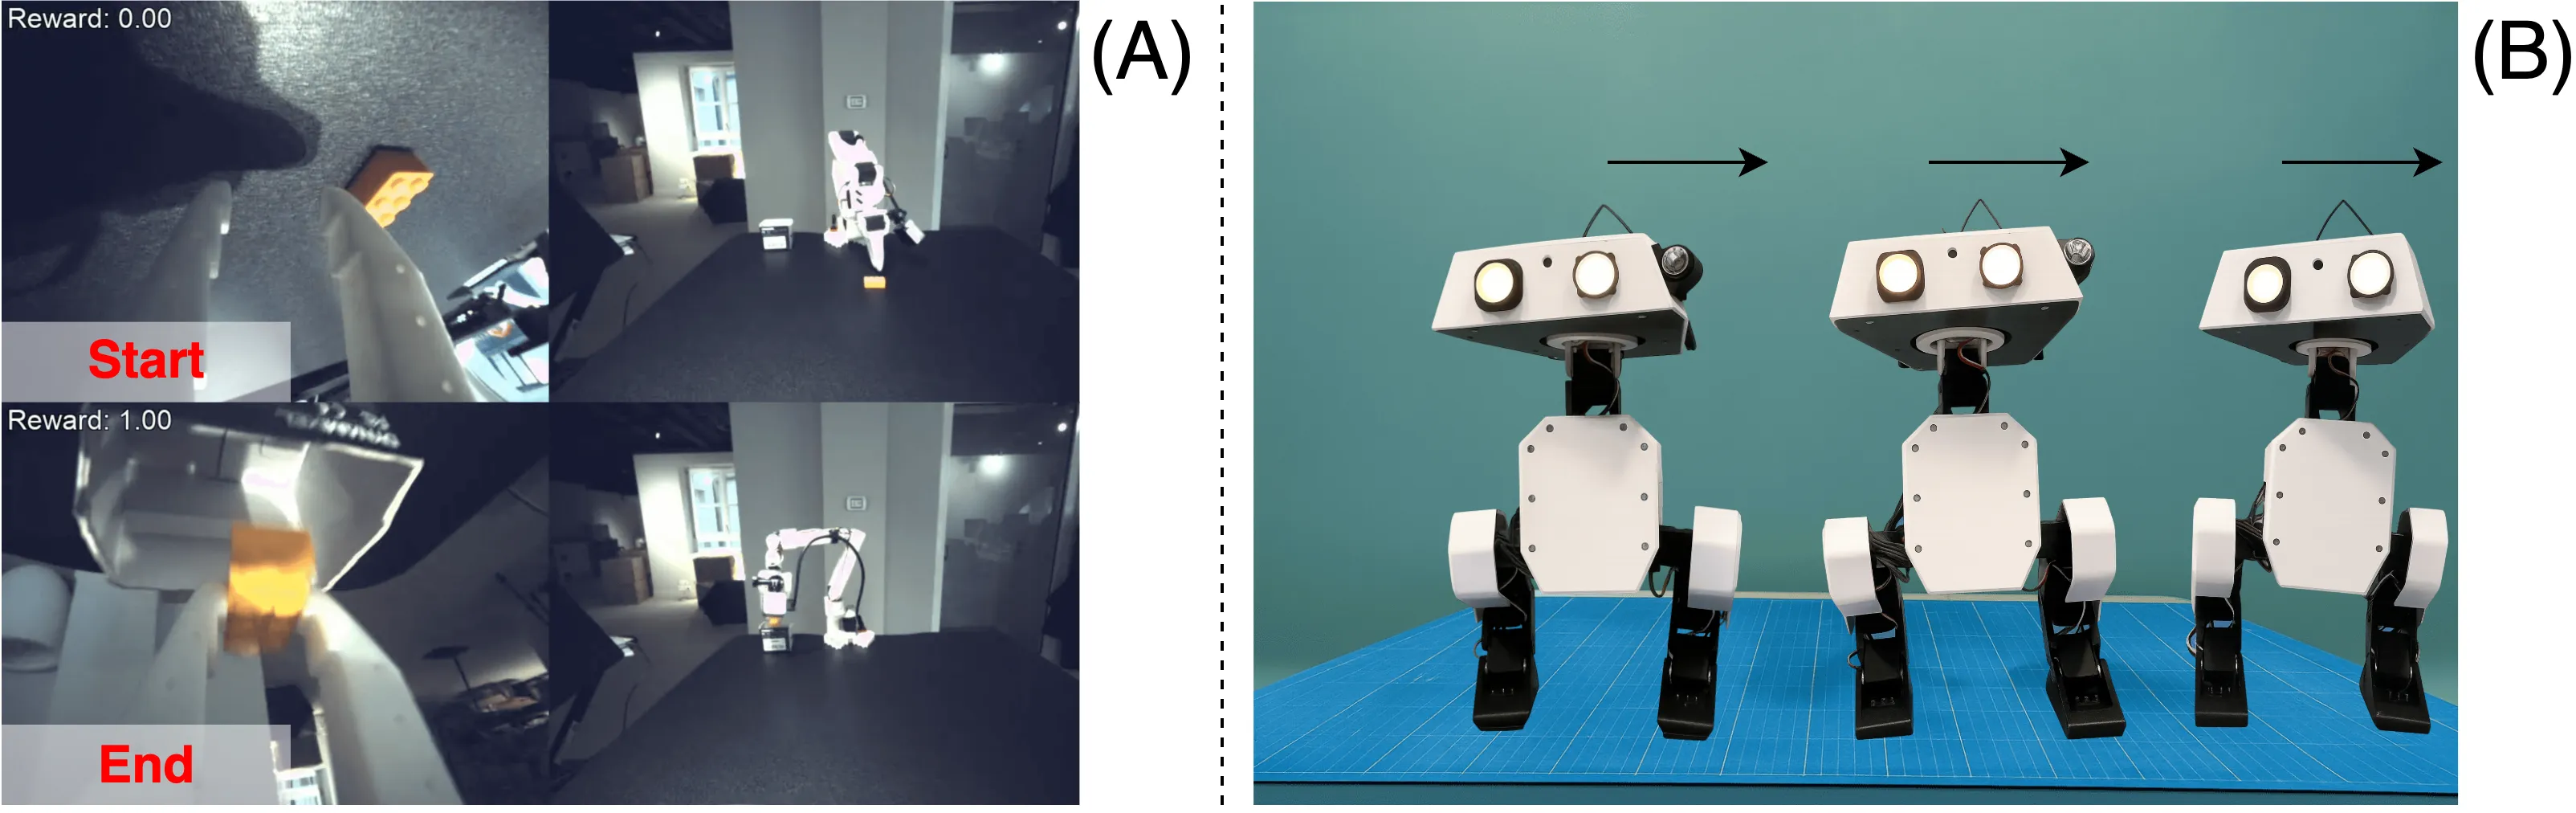
El método se probó en ocho tareas de manipulación Meta-World y tres tareas reales con robots Franka. Logró un mejor alineamiento de proceso y clasificación de rollouts de políticas que los métodos de referencia. En pruebas reales fuera de distribución, la misma recompensa aprendida generalizó zero-shot a cambios de posición, perspectiva y apariencia del objeto, un resultado que los autores describen como habilitar "una representación de recompensa única para reutilizarse en diversas variantes de tarea en la práctica".
| Enfoque | Datos requeridos | Generalización | OOD en el mundo real |
|---|---|---|---|
| Aprendizaje de recompensa tradicional | 100+ demostraciones | Pobre | No demostrado |
| Marco de recompensas invariantes | 5 demostraciones | Zero-shot: posición/perspectiva/objeto | Demostrado en 3 experimentos |
| Modelos de visión de referencia | 50+ demostraciones | Limitada (cambios menores de perspectiva) | Fallo en OOD |
La capacidad zero-shot es particularmente significativa: la recompensa aprendida en un laboratorio con una sola instancia de objeto se transfirió directamente a nuevas formas de objeto, diferentes alturas de mesa y condiciones de iluminación que el sistema nunca había encontrado. Los autores señalan que "la misma recompensa aprendida generaliza zero-shot a variaciones de posición, perspectiva y objeto", lo que aborda directamente una de las mayores barreras para implementar RL en entornos de producción.
¿Cómo acelera esto el aprendizaje de políticas posteriores?
Al proporcionar una señal de recompensa estable y generalizable, el marco permite que las políticas de RL posteriores aprendan más rápido y se transfieran entre tareas. La recompensa invariante reduce el espacio de búsqueda para la política, permitiéndole centrarse en el control motor en lugar de volver a aprender los objetivos de la tarea para cada variación.
En configuraciones tradicionales, un robot debe ser reentrenado desde cero para cada nueva posición de objeto o colocación de cámara; cada variante se convierte efectivamente en una nueva tarea. Con recompensas invariantes, la política puede entrenarse una vez y luego ajustarse para entornos específicos usando la misma función de recompensa. Los experimentos mostraron un mejor alineamiento de proceso, lo que significa que las políticas no solo alcanzaron el objetivo, sino que lo hicieron mediante estrategias que reflejaban el comportamiento demostrado. Para los integradores de robótica, esto se traduce en menos tiempo de ingeniería: en lugar de semanas de ajuste de recompensa por estación de trabajo, se puede aprender una recompensa general a partir de un puñado de demostraciones humanas y aplicarse en toda una línea de fábrica.
¿Qué significa la generalización zero-shot para la robótica?
Generalización zero-shot significa que un robot puede recoger un objeto que nunca ha visto, en una posición nunca alcanzada, bajo condiciones de iluminación nunca experimentadas, usando la misma función de recompensa aprendida de solo cinco demostraciones iniciales. Esta es una capacidad crítica para la manipulación en entornos abiertos donde cada entorno es único.
Para la automatización de almacenes, esto podría significar que un solo brazo robótico maneje paquetes entrantes de tamaño y colocación arbitrarios sin calibración previa. En la fabricación, un cobot podría aprender un nuevo paso de ensamblaje a partir de cinco demostraciones del operario y luego ejecutarlo en cualquier disposición de banco de trabajo. Los investigadores demostraron exactamente esto: sus experimentos reales fuera de distribución incluyeron desplazar el objeto objetivo por el espacio de trabajo, rotar la cámara a un ángulo completamente nuevo y cambiar el objeto por otro de diferente forma y color; todo manejado por la misma recompensa aprendida. Las implicaciones para el costo de despliegue son sustanciales: en lugar de pagar a integradores de sistemas por ingeniería de recompensa específica del sitio, los usuarios finales podrían recibir una recompensa preentrenada que se adapte sobre la marcha.
Implicaciones para la robótica
Para los equipos de robótica que evalúan el aprendizaje por refuerzo para manipulación, este marco aborda directamente los problemas de eficiencia de datos y generalización que han mantenido la automatización basada en RL fuera de la mayoría de los despliegues comerciales. La capacidad de aprender de cinco demostraciones en lugar de cientos reduce la barrera de entrada para pequeñas y medianas empresas. Además, la generalización zero-shot significa que una sola recompensa puede compartirse entre múltiples celdas de trabajo, reduciendo el costo total de propiedad.
Para los compradores interesados en robots colaborativos usados en Robot Overflow o robots industriales usados, esta investigación apunta hacia un futuro donde los robots sean más adaptables sin requerir costosa programación personalizada. Si bien el marco aún está en etapa de investigación, sus requisitos mínimos de datos y su rendimiento probado en OOD real sugieren que podrían aparecer kits comerciales con ideas similares en uno o dos años. Los robóticos deberían monitorear el enfoque híbrido simbólico-numérico como una alternativa potencial a los modelos de recompensa puramente neuronales.
Preguntas frecuentes
¿Cuántas demostraciones se requieren? El marco funciona con tan solo cinco demostraciones. Los experimentos utilizaron cinco demostraciones proporcionadas por humanos para aprender funciones de recompensa invariantes que generalizan zero-shot.
¿Requiere un simulador? No se necesita interacción en línea ni simulador para el paso de aprendizaje de recompensa. El procedimiento híbrido simbólico-numérico extrae invariantes puramente de las demostraciones proporcionadas. El aprendizaje de política posterior puede usar simulador o rollouts del mundo real.
¿Qué tipos de tareas se probaron? El método se evaluó en ocho tareas de referencia Meta-World (incluyendo empujar, recoger y ensamblar) y tres tareas de manipulación real con robots Franka Emika que involucran pick-and-place e inserción de clavijas.
¿Puede funcionar con diferentes brazos robóticos? El marco es independiente del brazo. Aprende invariantes a nivel de tarea independientes de la cinemática del robot, por lo que la misma recompensa puede transferirse entre diferentes manipuladores siempre que el objetivo de la tarea siga siendo el mismo.
¿Está listo para despliegue comercial? El marco ha sido validado en experimentos reales fuera de distribución, pero sigue siendo una contribución académica. La adopción comercial requeriría integración en pilas de RL estándar y validación en una gama más amplia de tareas.
¿Cómo se compara con el aprendizaje por imitación? El aprendizaje por imitación copia acciones demostradas pero lucha con estados novedosos. Este marco aprende objetivos de tarea (recompensas) en lugar de políticas, permitiendo transferencia zero-shot a nuevas distribuciones de estado mientras permite que una política posterior descubra comportamientos óptimos.
Conclusión
Aprender recompensas invariantes a partir de solo cinco demostraciones representa un paso práctico hacia el aprendizaje por refuerzo desplegable en robótica. Al pasar de ajustar píxeles a invariantes de comportamiento, el marco resuelve el problema de generalización que ha limitado la adopción real de recompensas basadas en visión. A medida que los robóticos buscan reducir el costo de datos e ingeniería de la automatización, este enfoque ofrece un camino hacia robots que realmente entienden las tareas, no solo las condiciones visuales específicas bajo las cuales fueron enseñados.