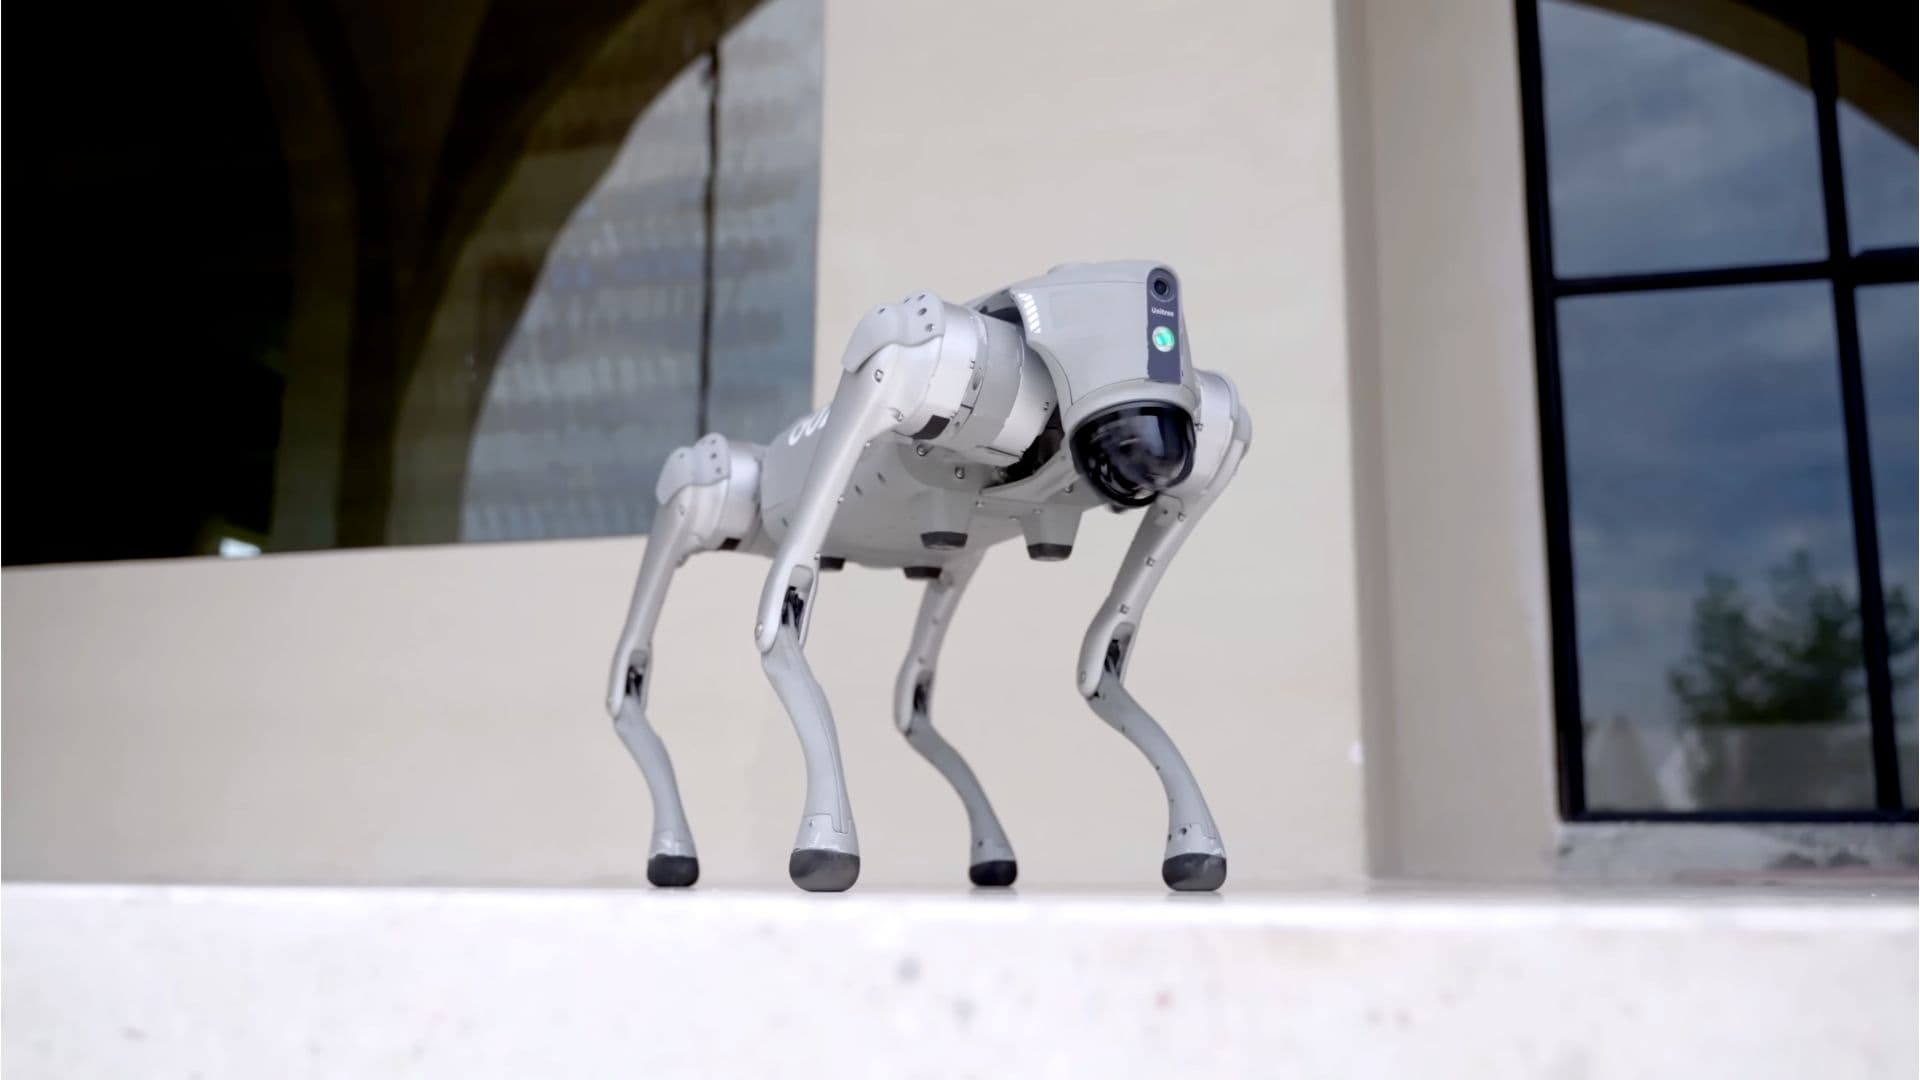
연구진은 Arxiv가 처음 소개한 연구에서 교사 8개를 활용해 사족 보행 로봇 정책 하나를 훈련하고 22개 과제를 수행하도록 했다. 이 기술 레퍼토리에는 걷기, 땅 파기, 깡충 뛰기 등이 포함되며, 이 방법은 이런 기술을 조합해 기어가기와 같은 새로운 동작을 구현할 수 있다. 완성된 정책은 Unitree B1 사족 보행 로봇에 적용됐다.
학습 과정은 여러 교사 정책으로 시작하며, 각 정책은 범위가 좁게 정의된 과제 하나를 강화학습으로 학습한다. 이어지는 두 단계에서는 다중 교사 증류를 통해 교사 정책들을 활용해 학생 정책을 훈련하고, 강화학습과 모방학습을 결합한 목적 함수를 사용한다. 적대적 과제 선택은 성능이 가장 낮은 과제에 학습을 집중시킨다.
강화학습을 통해 다족 보행 로봇은 단일 과제 환경에서 여러 기술을 수행할 수 있게 됐지만, 농업 로봇과 우주 탐사 같은 분야에는 다양한 능력이 필요하다. 여기에는 이동, 땅 파기, 근거리 조사 등이 포함된다. 하지만 샘플 효율이 낮고 과제 간 그래디언트 충돌이 발생해 엔드투엔드 다중 과제 학습은 어렵다.
평가 결과, 이 방법은 동작 품질을 유지하면서 PPO 및 증류 후 미세 조정 기준선보다 명령을 더 정확하게 추종했다. 일부 경우에는 학생 정책이 별도 학습 없이 새로운 과제에 일반화하기도 했다.
이 방법은 각 교사가 범위가 좁게 정의된 과제를 학습하는 동안, 폭넓은 과제 레퍼토리를 학생 정책 하나에 담는다. 완성된 정책은 실제 환경에서의 견고성을 입증하기 위해 Unitree B1 사족 보행 로봇에 적용됐다.