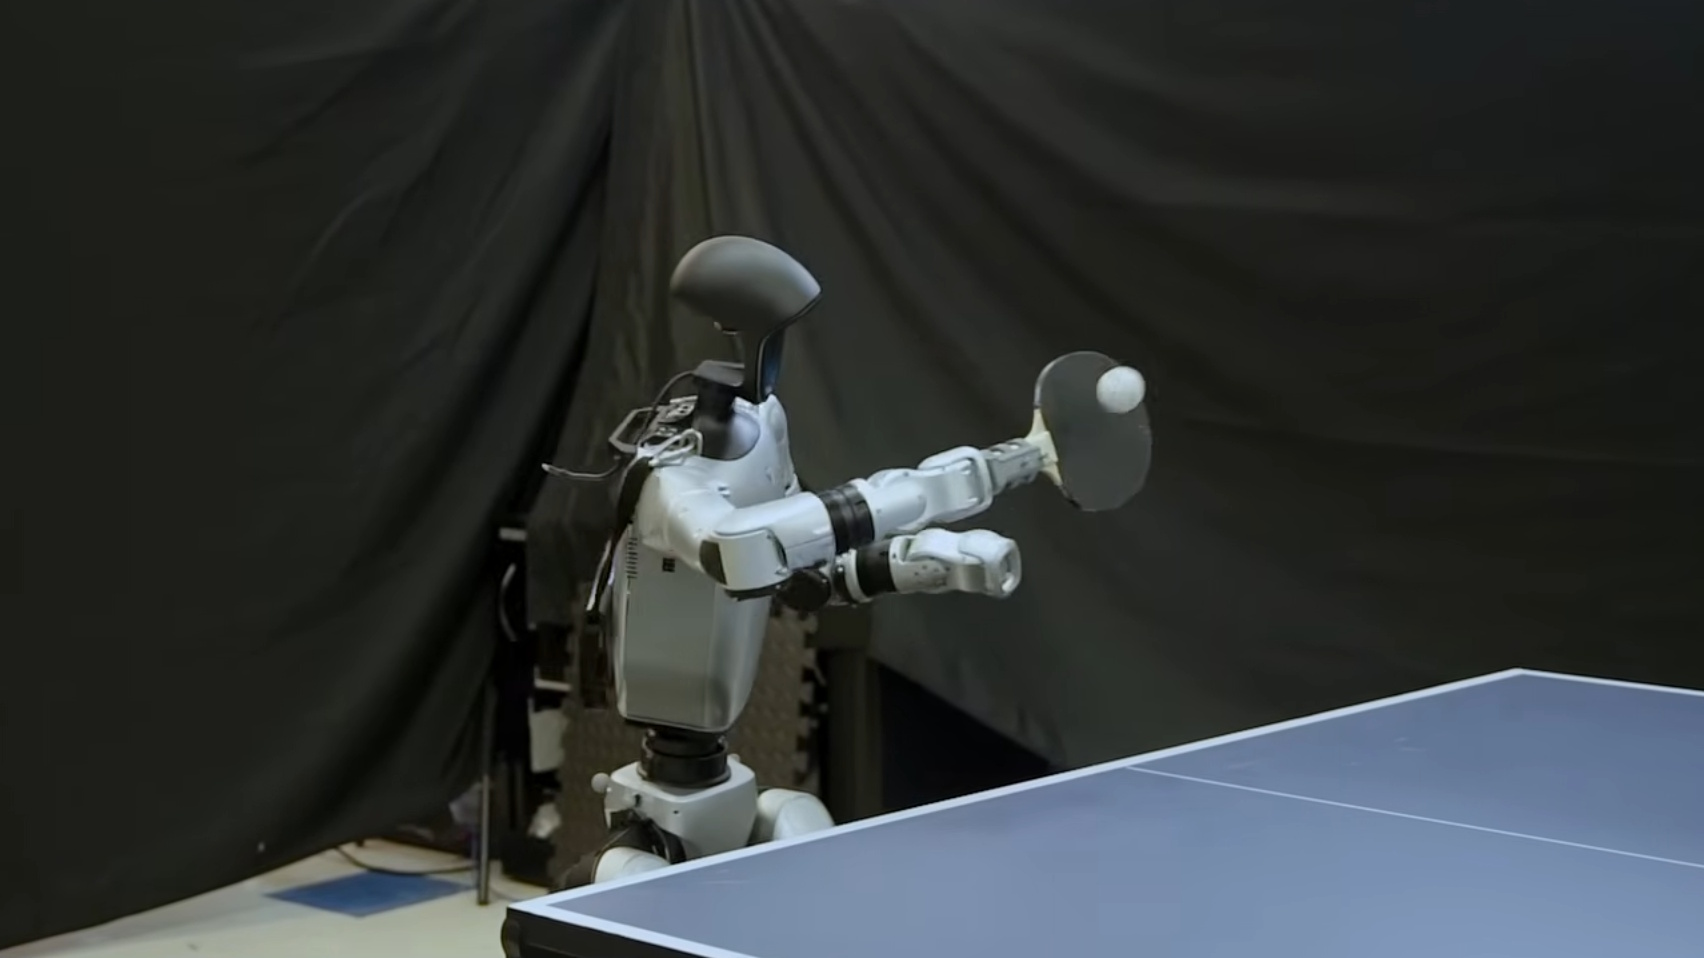
휴머노이드 탁구 시스템은 타격 실행과 타구 선택을 분리하고, 공의 목표 착지 지점을 두 작업을 연결하는 인터페이스로 활용합니다. Arxiv에 처음 보고된 연구입니다. 목표 선택 정책만 바꿨을 때 세 가지 기준 전략과의 경기 결과가 크게 달라졌으며, 학습된 전략은 각각 89%, 82%, 73%의 점수를 따냈습니다.
목표 착지 지점은 두 작업을 잇는 인터페이스 역할을 합니다. 모터 정책은 모델 기반 타격 계획기와 학습된 제어기를 사용해 요청된 목표를 실제로 수행 가능한 타격으로 변환합니다.
연구진은 폐루프 랠리에서 셀프플레이를 수행해 모터 정책을 개선했습니다. 이때 공은 미리 지정된 방식으로만 투입되는 것이 아니라 다른 플레이어가 생성했습니다. 이 단계에서는 상대를 고려하지 않고 목표를 선택했기 때문에, 훈련을 통해 실행 능력은 향상됐지만 시스템이 경기 전략을 학습한 것은 아닙니다.
모터 셀프플레이를 거친 뒤 랠리에서 목표 지점 정확도와 규정에 맞는 리턴 비율이 모두 향상됐습니다. 이어 연구진은 모터 스택 전체를 고정한 채 경쟁적 셀프플레이를 통해 타격 단위의 별도 정책을 학습시켜 목표 착지 지점을 선택하도록 했습니다.
중앙, 무작위, 상대가 없는 쪽을 겨냥하는 기준 전략을 상대로 학습된 전략은 각각 89%, 82%, 73%의 점수를 따냈습니다. 목표 선택은 고정된 위치에만 의존하지 않고 상대의 위치와 직전 목표에 따라 달라졌습니다.
모터 스택을 고정했으므로, 이 결과는 타격 제어기가 바뀐 것이 아니라 목표 선택 방식이 달라진 효과를 비교한 것입니다. 실제 하드웨어에서도 동일한 실행 스택과 전략 인터페이스를 사용해 레크리에이션 수준의 인간 상대와 11점제 경기를 끝까지 치렀으며, 포핸드와 백핸드 리턴을 주고받는 여러 차례의 타격으로 이어진 랠리도 진행했습니다.