GXO, Apollo 실증 시험 확대… 글로벌 도입 규모 최대 1,000대 전망

GXO, Apollo 실증 시험 확대… 글로벌 도입 규모 최대 1,000대 전망

실시간•11월 13일 오후 12:30•1분 읽기•
Liu Wei
Liu Wei

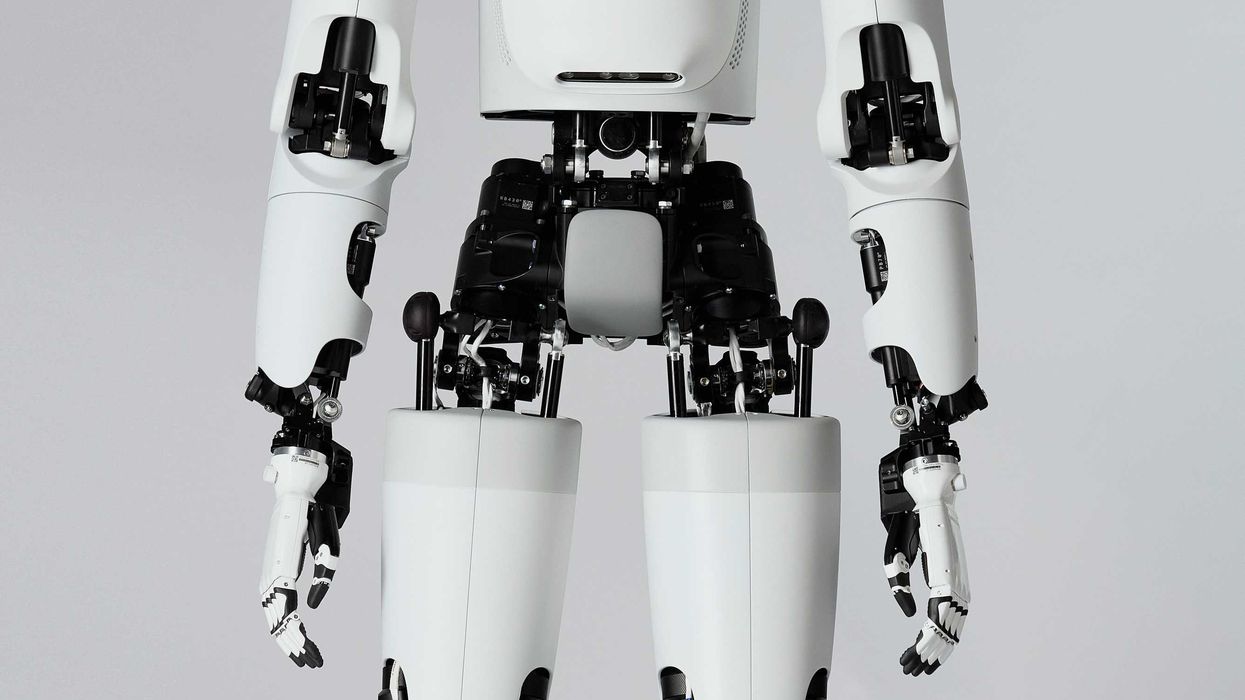
GXO와 Apptronik은 4년에 걸쳐 최대 1,000대의 로봇을 전 세계에 도입할 가능성을 앞두고 Apollo 실증 시험을 확대할 예정이다. 이 내용은 Dcvelocity가 처음 보도했다. 도입 확대는 배치가 성공하고 합의된 성능·안전·운영 KPI를 충족하는 데 달려 있다. 계획된 도입에는 Robotics-as-a-Service 모델이 적용되며, 북미 지역의 초기 배치는 2027년 말 시작될 예정이다.

시험은 2027년 시작될 예정이며, 상품이 작업자에게 이동하는 방식과 작업자가 상품으로 이동하는 방식의 피킹, 박스 및 토트 운반, 포장, 분류 작업을 다룬다. 양사는 규모를 확대한 배치에 필요한 안전·보안·기술 요건을 검증할 예정이다.

각 활용 사례는 양사가 공동으로 합의한 생산성·안전·운영 KPI를 기준으로 평가하고 진행 순서를 정한다. 이번 시험에서는 휴머노이드 로봇이 기존 자동화 설비 및 GXO 직원과 함께 작업하는 방식도 검증한다.

전 세계 도입을 목표로 하되 각 활용 사례를 평가한다는 방침이다. Apptronik의 CEO 겸 공동 창업자인 Jeff Cardenas는 이번 파트너십을 통해 “실제 가동 시설의 운영 KPI”를 기준으로 물류 현장에 휴머노이드 로봇을 투입하는 데 필요한 요건을 정립하고 있다고 말했다. 계획된 도입에는 Robotics-as-a-Service(RaaS) 모델이 적용될 예정이다.

GXO는 Apptronik 로봇의 실용적인 창고 활용 사례를 찾기 위해 2024년 개념 검증 시험을 시작했다. 2026년에는 조지아주 물류센터의 초기 적용에서 노스캐롤라이나주와 테네시주의 추가 창고로 협력이 확대됐다.

의향서에 따르면 북미 지역의 초기 배치는 2027년 말 시작될 예정이다.

중국 AI 모델 6종에서 포착된 Blackwell 초기화 지문

DeepSeek, Moonshot AI, MiniMax, Ant Group의 모델 6종에서 NVIDIA Blackwell GPU 구성과 일치하는 가중치 패턴이 확인됐다. 이 내용은 Unemploymentlabs가 처음 보도했다. 해당 증거는 이 모델들이 Blackwell 호환 초기화를 사용했음을 시사하지만, 칩이 어디에 있었는지, 어떤 방식으로 접근했는지, 수출 통제를 위반했는지는 밝혀내지 못한다.

6개 모델은 DeepSeek-V4-Flash와 V4-Pro, Moonshot AI의 Kimi K3와 K3.1-Pro, MiniMax-M3, Ant Group의 Ling-3.1-flash다. V4-Flash와 MiniMax-M3는 148-SM B200/B300 구성과 일치하며, 나머지 4개 모델은 152-SM GB200/GB300 구성과 일치한다.

이 지문은 공개된 가중치에 보존된 초기화 패턴에서 비롯된다. 시드와 GPU 스레드 구성을 복원하면 초기값을 생성한 하드웨어를 식별할 수 있지만, 이후 학습에 사용된 모든 가속기를 알아낼 수 있는 것은 아니다.

이전 세대 Hopper 지문은 DeepSeek-V3, Kimi K2.5, MiniMax-M2.7, Ling-3.0-flash에서 나타난다. Kimi K2.7-Code는 중간 사례다. Hopper 세대 가중치에 B200/B300과 일치하는 부분이 소량 포함돼 있다. Blackwell과 일치하는 모델은 2026년 4월 DeepSeek-V4, 6월 MiniMax-M3, 7월 Kimi K3, 10월 Ling-3.1-flash, 11월 Kimi K3.1-Pro 순으로 공개됐다.

이 공개 순서는 네 곳의 연구소에서 초기화 지문이 바뀌었음을 보여줄 뿐, 전체 학습 과정에 Blackwell이 사용됐다는 증거는 아니다.

6개 모델에서 가장 강한 증거는 49에서 1,385 sigma에 달했고, 개별 검사 중 가장 낮은 값도 20 sigma였다. 특수 설정을 적용한 AMD MI300X에서도 같은 구성을 재현할 수 있다. V4-Flash의 경우 AMD와 NVIDIA 결과가 서로 달랐던 377개 값 중 363개가 NVIDIA와 일치했고, AMD와 일치한 값은 없었다. 같은 검사로는 나머지 5개 모델을 판별하지 못했지만, AMD를 사용했다는 설명은 가능성이 매우 낮은 것으로 평가된다.

5개 모델의 학습 실행 추정치에 따르면, 초기화에 사용된 하드웨어가 해당 모델 학습에도 쓰였다고 가정할 때 각 모델에는 2~3개월 동안 Blackwell GPU 약 500~3,000개가 필요했을 것으로 보인다. GPU 한 대당 약 $70,000으로 계산하면 가장 큰 클러스터의 비용은 1억5,000만~2억 달러에 이르고, 5개 모델의 최종 학습 실행 비용만 합쳐도 5억 달러를 넘는다. 연구소들이 수출 통제 대상 GPU에 지출한 총액은 수십억 달러에 이를 가능성이 높다.

이 Blackwell 칩을 중국으로 수출하려면 미국의 허가가 필요하지만, 허가가 발급됐다는 보고는 없다.

Alibaba(Qwen), Zhipu(GLM), Tencent, Xiaomi, StepFun에서 공개한 최신 판독 가능 모델은 여전히 Hopper와 일치했다. Meituan은 LongCat-2.0이 AI ASIC 슈퍼팟에서만 학습됐다고 밝혔으며, 공개된 가중치에서는 NVIDIA 지문이 나타나지 않았다.