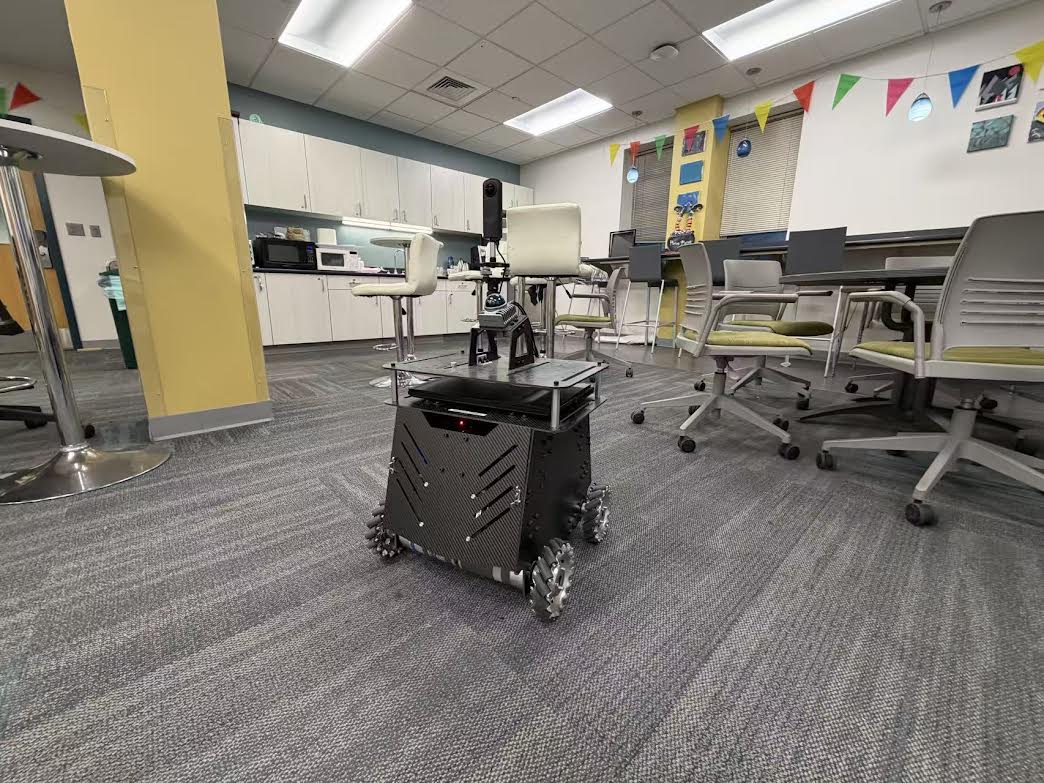
대부분의 로봇 내비게이션 벤치마크는 테스트가 시작되기도 전에 정답을 알려준다. 미리 만들어진 지도, 라벨이 붙은 객체, 구조화된 환경이 제공된다. 하지만 Carnegie Mellon University의 Robotics Institute는 이 안전장치를 의도적으로 없애고 있다. 차기 Vision-Language-Navigation(VLN) Challenge는 ‘ground truth’를 완전히 제거한다. 참가 팀은 원시 센서 데이터를 해석하고, 낯선 공간을 추론하며, 미리 입력된 정보에 의존하지 않고 자연어 지시를 따라야 한다.
- CMU Vision-Language-Navigation Challenge란?
- ground truth 제거가 모든 것을 바꾸는 이유
- 챌린지는 어떻게 진행되나: 시뮬레이션에서 실제 로봇까지
- 이 연구가 열어갈 응용 분야는?
- 로보틱스에 갖는 의미
- 자주 묻는 질문
CMU Vision-Language-Navigation Challenge란?
VLN Challenge는 Carnegie Mellon University의 Robotics Institute가 주최하는 연구 경진대회다. 미리 정의된 지도나 라벨이 붙은 객체 데이터 없이, 자율 시스템이 자연어 지시를 얼마나 잘 해석하고 실제의 비정형 물리 환경을 이동할 수 있는지 평가한다. 참가 팀은 추론 소프트웨어를 개발하고, CMU는 하드웨어 플랫폼을 제공한다.
이 챌린지는 언어와 지각에 기반한 이해를 신뢰할 수 있는 물리적 행동으로 바꾸는 분야, 즉 점점 더 Physical AI라고 불리는 영역의 핵심에 자리 잡고 있다. 로봇에게 “부엌으로 가서 앉을 곳을 찾아”라고 말한 뒤, 한 번도 본 적 없는 건물에서 실제로 그 일을 수행하게 만드는 것은 여전히 로보틱스의 가장 어려운 미해결 과제 중 하나다. Carnegie Mellon's Robotics Institute에 따르면 이번 대회 단계는 완성도 높은 실험실 시연과 진정한 자율 능력 사이의 간극을 좁히기 위해 설계됐다.
ground truth 제거가 모든 것을 바꾸는 이유
대부분의 벤치마크가 암묵적으로 제공하는 미리 정의된 라벨, 객체 식별 정보, 공간 좌표를 없애는 것은 이번 챌린지에서 가장 중요한 설계 결정이다. 시스템이 사람이 자연스럽게 하는 일을 하도록 강제하기 때문이다. 처음 가본 장소에 도착해 주변을 파악하는 일이다.
기존 VLN 벤치마크에서는 데이터셋 태그 덕분에 로봇이 눈앞의 물체를 의자라고 ‘알고’ 있을 수 있다. 하지만 여기서는 실제 현장에서 제공되는 것과 같은 원시 LiDAR(light detection and ranging, 레이저 펄스를 발사해 3D 포인트 클라우드를 만드는 센서) 데이터와 360도 카메라 영상만으로 이를 추론해야 한다.
더 근본적으로 요구되는 능력은 의미·공간 추론이다. 물체가 무엇인지뿐 아니라, 공간적 맥락에서 어떤 역할을 하는지까지 이해해야 한다는 뜻이다. 이 챌린지를 총괄하는 Shanghai Jiao Tong University 출신 RI 교환학생 Jingfan Tang은 그 차이를 이렇게 설명했다. “복도는 단순히 좁은 공간이 아닙니다. 복도는 여러 방을 연결하고 사람들이 건물 안에서 이동하는 방식을 결정합니다.” 복도를 그저 ‘통로’로 분류할 뿐 연결 기능까지 이해하지 못하는 시스템은 “회의실 근처 복도에서 만나자”처럼 맥락이 담긴 지시를 받는 순간 잘못된 판단을 내리게 된다.
바로 이 지점에서 현재의 대규모 언어 모델 기반 내비게이션 시스템이 자주 한계를 드러낸다. 지시는 유창하게 해석하지만, 환경에 대한 공간 모델이 모호하거나 불완전하면 일관성을 잃는다.
챌린지는 어떻게 진행되나: 시뮬레이션에서 실제 로봇까지
대회는 난도를 단계적으로 높이는 2단계 구조로 진행된다. 참가 팀은 먼저 맞춤형 시뮬레이션 환경에서 하드웨어 제약 없이 추론 아키텍처를 개발하고 한계까지 시험한다. 2단계에서는 CMU의 실제 플랫폼을 활용한 로봇 테스트로 넘어간다. 이 플랫폼에는 3D LiDAR와 360도 카메라가 탑재되어 있어 센서 잡음, 조명 변화, 물리적 불확실성을 피할 수 없다.
| 단계 | 환경 | 주요 초점 |
|---|---|---|
| 1단계 | 맞춤형 시뮬레이션 | 알고리즘 개발, 의미 추론 |
| 2단계 | 실제 로봇 하드웨어 | 센서 통합, 실제 환경에서의 견고성 |
| 최종 발표 | IROS 2026, Pittsburgh | 결과 발표와 연구 교류 |
참가 팀이 맡는 것은 추론 및 내비게이션 소프트웨어 스택뿐이다. 센서 데이터와 언어를 이동 명령으로 변환하는 지각-의사결정 파이프라인을 개발하면 된다. CMU가 물리적 플랫폼을 제공하므로 참가 장벽은 하드웨어 확보가 아니라 지능 구현에 맞춰진다.
챌린지는 Pittsburgh에서 열리는 2026 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS)에서 워크숍과 함께 마무리된다. 팀들은 이 자리에서 연구 결과를 더 넓은 연구 커뮤니티에 발표한다. 연구 그룹을 자문하는 RI Systems Scientist Ji Zhang은 통제된 실험실 환경 밖에서 작동하는 시스템을 구축해 온 연구소의 경험 덕분에 CMU가 이 과제를 수행하기에 적합하다고 설명했다.
이 연구가 열어갈 응용 분야는?
이번 챌린지가 겨냥하는 기술적 발전은 여러 로봇 도입 분야에 직접적인 영향을 미칠 수 있다. Ji Zhang은 그 의미를 분명히 짚었다. “비전-언어 내비게이션의 발전은 더욱 유능한 가정용 보조 로봇, 향상된 수색·구조 로봇, 그리고 산업 현장의 더 똑똑한 도구로 이어질 수 있습니다.”
분야별로 살펴보면 다음과 같다.
서비스 및 가정용 로보틱스 — 미리 입력된 평면도 없이도 음성 지시를 받고 낯선 집 안을 이동하는 로봇 보조기는 사용성을 획기적으로 높일 수 있다. 현재의 가정용 로봇은 안정적으로 작동하려면 대부분 먼저 공간을 매핑해야 한다.
수색·구조 — 재난 현장은 구조화된 데이터셋과 정반대의 환경이다. 건물이 무너지고 통로가 막히며, 사전에 준비된 지도도 없다. 실시간 센서 데이터로 공간을 추론하고 작업자의 자연어 지시에 응답하는 로봇이라면 GPS나 지도에 의존하는 시스템이 완전히 무력해지는 곳에서도 활동할 수 있다.
산업 및 물류 자동화 — 창고의 배치는 바뀌고, 새 시설에는 다시 매핑이 필요하다. 미리 프로그래밍된 지도 대신 원시 관측 데이터에서 공간 관계를 추론하는 내비게이션 시스템은 동적인 환경에 자율 이동 로봇을 배치할 때 드는 통합 부담을 줄여준다. 현재 세대의 시스템이 구조화된 환경을 어떻게 다루는지 궁금하다면 Robot Overflow에서 산업용 로봇을 살펴볼 수 있다. VLN 연구가 향하는 방향은 차세대 시스템이 나아가야 할 곳을 보여준다.
로보틱스에 갖는 의미
CMU VLN Challenge는 체화된 AI 분야 전체를 점검하는 기준점이다. 벤치마크 성능과 실제 환경에서의 견고성이 과연 같은 것인지 정면으로 묻기 때문이다.
하드웨어 개발자에게 이 챌린지는 센서 구성이 어느 방향으로 개선되어야 하는지 보여준다. LiDAR에만 의존하는 시스템은 의미 이해에 어려움을 겪고, 카메라에만 의존하는 시스템은 깊이 정보를 파악하기 힘들다. 이번 과제는 두 센서의 결합을 요구하며 센서 융합 연구를 한 단계 밀어붙인다.
소프트웨어 및 AI 팀에게 ground truth 제거는 현재의 파운데이션 모델 접근법에 대한 직접적인 도전이다. LLM과 비전-언어 모델은 구조화된 환경에서 뛰어난 지시 이행 능력을 보여왔다. 이번 챌린지가 던지는 질문은 그 능력이 원시적이고 noisy하며 라벨조차 없는 물리적 현실과 마주했을 때도 유지되는가이다.
자율 이동 로봇(AMR)을 구매하거나 운영하는 기업, 특히 물류·의료·시설 관리 분야의 기업에게 이런 챌린지로 이어지는 연구 흐름은 차세대 상용 하드웨어의 바로 전 단계에 해당한다. 사전 매핑 없이 이동할 수 있는 시스템은 도입 과정의 마찰을 크게 줄인다. 오늘 중고 협동로봇 매물이나 자율 이동 플랫폼을 검토하고 있다면, 여기서 시험하는 능력은 앞으로 몇 세대의 하드웨어를 거쳐 상용 시장에 등장할 기능이라고 볼 수 있다.
더 넓게 보면 이는 표준을 세우는 작업이기도 하다. 챌린지의 명시적인 목표 중 하나는 Physical AI를 위한 새로운 글로벌 벤치마크를 마련하는 것이다. 연구에서 내세우는 지능 수준이 비정형 환경에서의 안정적인 자율 행동으로 이어지는지 확인하겠다는 뜻이다.
자주 묻는 질문
CMU Vision-Language-Navigation Challenge란 무엇인가?
Carnegie Mellon University's Robotics Institute가 주최하는 연구 경진대회다. 참가 팀은 미리 정의된 지도나 라벨이 붙은 객체, 구조화된 환경 데이터 없이 원시 센서 데이터만으로 자연어 지시를 해석하고 낯선 물리 환경을 이동할 수 있는 소프트웨어 시스템을 개발한다.
참가자들은 어떤 하드웨어를 사용하나?
CMU는 3D LiDAR(light detection and ranging) 센서와 360도 카메라를 갖춘 로봇 플랫폼을 제공한다. 참가 팀은 센서 데이터를 처리하고 로봇의 의사결정을 이끄는 추론 및 내비게이션 소프트웨어 개발에만 집중한다.
실제 로보틱스에서 ground truth를 제거하는 것이 중요한 이유는 무엇인가?
ground truth, 즉 미리 라벨링된 객체 식별 정보와 공간 좌표는 실제 도입 환경에 존재하지 않는다. 이를 제거하면 시스템은 원시 센서 데이터만으로 객체가 무엇인지, 공간들이 어떤 관계를 맺는지 추론해야 한다. 따라서 벤치마크 성능이 실제 역량을 얼마나 잘 예측하는지 더욱 정확하게 평가할 수 있다.
VLN Challenge는 언제 어디서 마무리되나?
Pittsburgh에서 열리는 2026 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS)의 워크숍에서 마무리된다. 참가 팀은 더 넓은 로보틱스 및 AI 연구 커뮤니티를 대상으로 결과와 연구 성과를 발표한다.
연구자는 어떻게 VLN Challenge에 등록할 수 있나?
대회를 운영하는 AI-Meets-Autonomy 이니셔티브가 제공하는 VLN Challenge 웹사이트에서 등록하고 자세한 내용을 확인할 수 있다.
비전-언어 내비게이션의 발전으로 가장 큰 혜택을 받을 산업은 무엇인가?
가장 큰 영향을 받을 분야는 가정 및 서비스 로보틱스(낯선 집 안에서의 이동), 수색·구조(비정형 재난 환경), 산업 물류(사전 매핑된 배치가 자주 바뀌는 동적 창고)다. 세 분야 모두 환경에 대한 사전 지식 없이 공간을 추론하는 능력을 필요로 한다.
CMU VLN Challenge는 구조화된 데이터셋 대신 현실 세계의 복잡성을 택하며, 로보틱스 벤치마크가 안주해 온 한계에 정면으로 도전한다. 연구 커뮤니티가 이 기준을 충족할 수 있을지는 앞으로 수년간 실제 도입 가능한 Physical AI의 발전 방향을 좌우할 것이다.
ground truth 없는 내비게이션의 혜택을 가장 먼저 보게 될 분야는 가정용 로보틱스, 수색·구조, 산업 물류 중 어디라고 생각하는가?