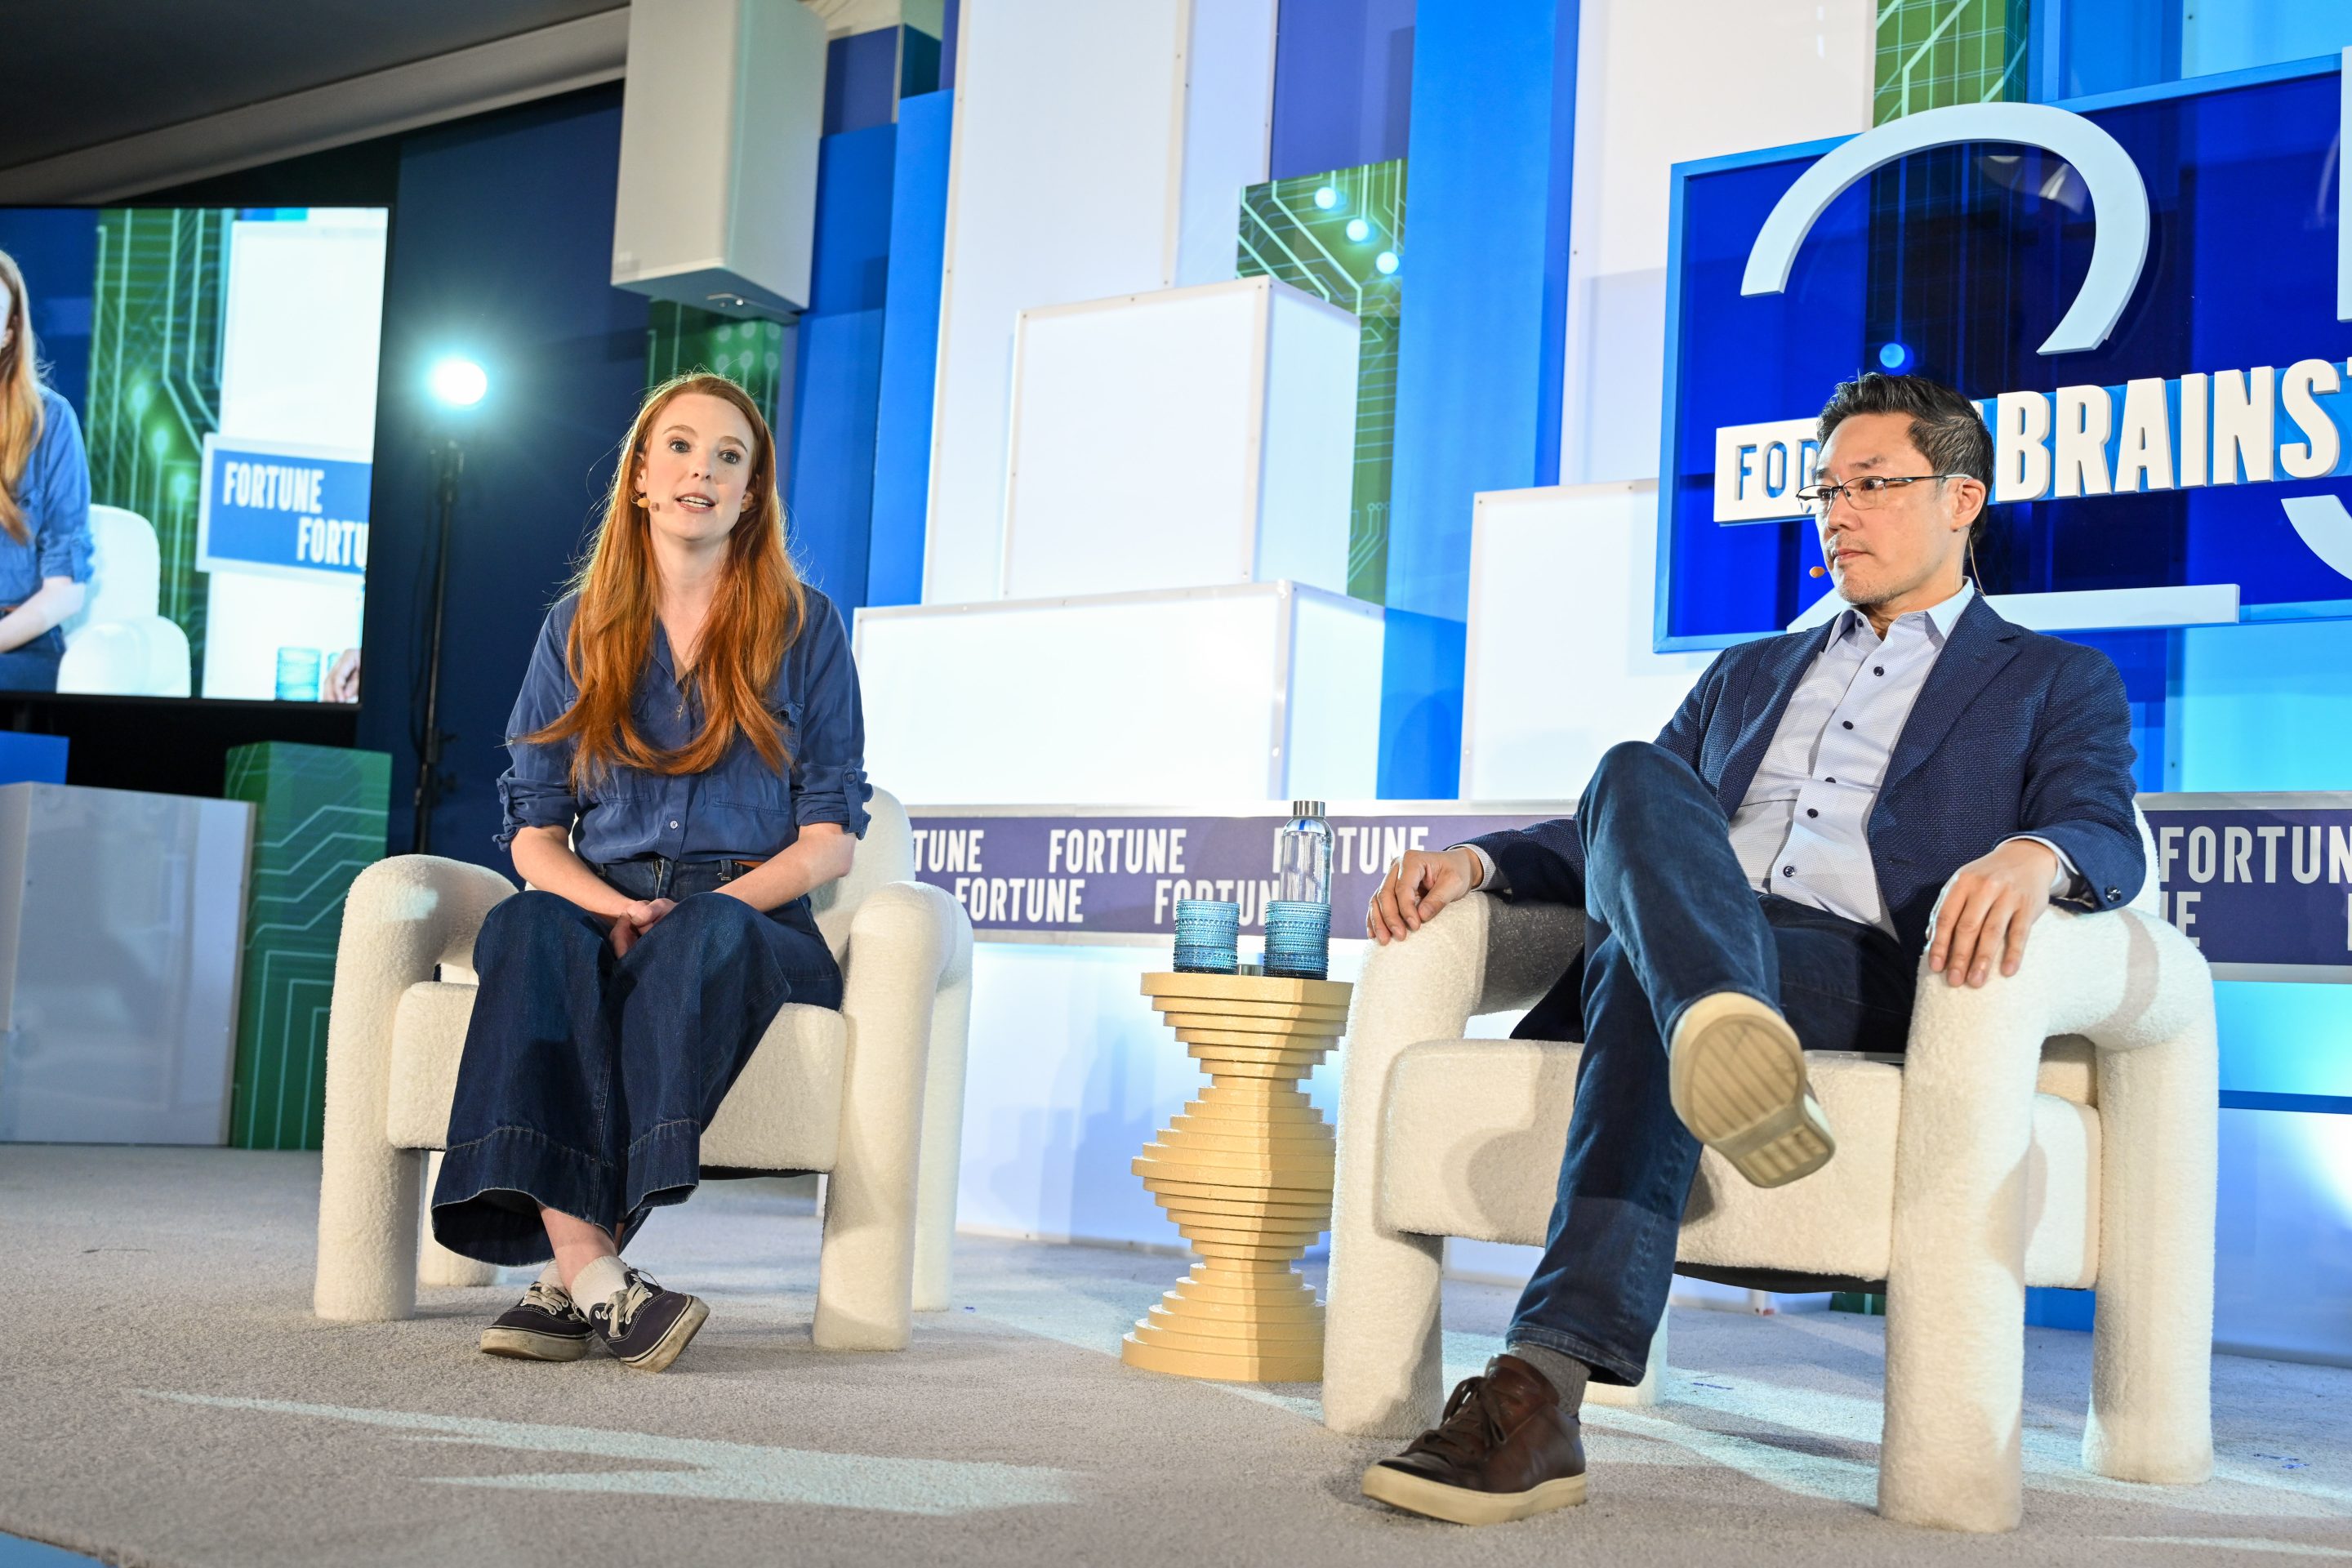
AI 업계가 수년간 집착해온 '더 큰 모델'에서 벗어나, 이 시스템들을 대규모로 배포할 수 있을 만큼 효율적으로 만드는 긴급한 과제로 방향을 전환하고 있다. Fortune의 Brainstorm Tech 컨퍼런스에서 임원들은 '모놀리식' 모델의 시대가 끝나고 있다고 주장했으며, Adaption의 CEO Sara Hooker와 SambaNova의 CEO Rodrigo Liang은 AI를 구축하고 운영하는 방식의 근본적인 변화를 촉구했다.
모놀리식 모델의 문제
지난 몇 년 동안 AI의 지배적인 내러티브는 '클수록 좋다'였다. 새로운 모델이 출시될 때마다 파라미터 수는 수천억 또는 수조 개로 늘어났다. 하지만 스타트업 AI 연구소 Adaption의 공동 창립자이자 CEO인 Sara Hooker는 이러한 접근 방식이 근본적인 비효율성을 초래했다고 주장했다.
"오늘날 대부분의 AI는 모놀리식(monolithic)입니다. 한 번 훈련된 모델의 지식과 능력은 사실상 고정됩니다. 세상에 변화가 생기거나 모델이 사용자로부터 유용한 것을 학습해도, 그 지식이 자동으로 모델에 통합되지 않습니다."라고 그녀는 컨퍼런스에서 말했다.
Hooker는 이를 규모에 따라 더욱 악화되는 구조적 문제라고 설명했다. AI 에이전트를 배포하는 기업들은 모델이 실수로부터 학습하지 않기 때문에 동일한 오류에 대해 컴퓨팅, API 호출, 인프라 비용을 반복해서 지불하고 있다. "진화할 수 있는 모델이 필요합니다. 그렇지 않으면 막대한 비효율이 발생합니다."라고 그녀는 강조했다.
효율성이 중요한 이유
이러한 시급성은 경제적 요인에 기인한다. Hooker에 따르면, 문제의 약 90%는 대규모 모델이 필요하지 않을 정도로 단순하다. "예를 들어, 대량 처리에서 많은 작업을 할 때 거대한 모델을 투입해서는 안 됩니다."라고 그녀는 말했다.
그녀는 현재를 "모델 크기의 곡선을 바꿔야 하는 엄청난 시급성을 가진 변곡점"이라고 묘사했다. 기업들이 경험하고 있는 치솟는 API 비용은 모든 작업에 고정되고 과도하게 큰 모델을 사용한 직접적인 결과다. 미래의 AI 시스템은 정적 모델에 반복적으로 호출하는 대신 새로운 정보에 지속적으로 적응하고 행동을 빠르게 변경할 수 있어야 한다고 그녀는 주장했다.
'규모 자체를 위한 규모'에서 적응형이고 효율적인 배포로의 이러한 전환은 AI 업계의 비용 구조를 극적으로 변화시킬 수 있다. 기업들은 점점 더 큰 모델을 훈련하는 데 수십억 달러를 지출하는 대신, 현장에서 학습하고 시간이 지남에 따라 운영 비용이 낮아지는 시스템에 투자하게 될 것이다.
하드웨어 경쟁 심화
모델 개발자들이 아키텍처와 훈련 방법을 통해 효율성을 추구하는 동안, 하드웨어 기업들은 다른 길을 가고 있다. AI 칩 기업 SambaNova의 CEO Rodrigo Liang은 당면 과제는 오늘날의 수조 파라미터 모델을 실제 배포에 적합할 만큼 저렴하게 실행하는 것이라고 말했다.
"수조 파라미터 모델은 여전히 너무 비싸고 전력을 많이 소모합니다."라고 Liang은 말했다. 그의 회사 전략은 대규모 모델 워크로드를 위해 특별히 설계된 칩을 통해 더 낮은 전력 소비로 더 빠른 추론을 제공하는 것이다. 그는 SambaNova의 하드웨어가 "동일한 모델에서 Nvidia Blackwell GPU보다 2~3배 더 나은 성능"을 제공한다고 주장했으며, 대규모로 볼 때 이러한 효율성 향상이 비용을 줄이는 가장 직접적인 경로라고 주장했다.
Liang은 가장 큰 모델이 당장 사라지지는 않을 것이라고 인정했지만, "더 효율적인 모델이 등장할 여지가 충분하다"고 예측했다. 현재 고객들은 확장 비용, 에너지 집약적 인프라, AI 인재 부족으로 어려움을 겪고 있다.
업계에 미치는 영향
규모에서 효율성으로의 거시적 전환은 투자자, 경쟁사, 그리고 광범위한 기술 생태계에 중요한 의미를 갖는다.
투자자에게: '더 큰 AI 모델 = 더 나은 수익'이라는 내러티브는 사라지고 있다. 비용 효율적인 배포와 실제 ROI를 입증할 수 있는 기업은 더 높은 가치 평가를 받을 가능성이 높다. SambaNova와 같이 효율성 지표에서 Nvidia의 지배력에 도전한다고 주장하는 하드웨어 스타트업은 더 매력적으로 보이지만, Nvidia의 생태계 잠금에 맞서 거대한 난관에 직면해 있다.
경쟁사에게: AI 칩 시장에서 Nvidia의 장악력은 대규모 모델 훈련을 위한 달러당 성능에 기반한다. 업계가 추론 중심의 적응형 시스템으로 전환하면, 특수 추론 칩을 갖춘 기업에게 유리한 고지가 넘어갈 수 있다. AMD, Intel, 그리고 목적에 맞게 설계된 실리콘을 제공하는 스타트업이 점유율을 높일 수 있다.
기술 업계 전반에: 기업의 AI 도입은 비용 초과로 인해 방해를 받아왔다. 모델을 더 저렴하게 실행하고 더 적응적으로 만들 수 있다면 배포 장벽이 낮아진다. 이는 실험적인 AI 파일럿에서 금융, 의료, 엔터프라이즈 소프트웨어 전반의 프로덕션 시스템으로의 전환을 가속화할 수 있다.
자주 묻는 질문
'모놀리식' AI 모델이란 무엇인가요? 모놀리식 모델은 한 번 훈련된 후 고정되는 모델입니다. 처음부터 다시 훈련하지 않고는 새로운 정보를 통합하거나 사용자 상호작용에서 학습할 수 없어 비효율을 초래합니다.
왜 기업들이 더 큰 모델 대신 효율성에 집중하고 있나요? 수조 파라미터 모델을 대규모로 실행하는 비용이 감당하기 어려워졌습니다. 많은 실제 작업에 가장 큰 모델이 필요하지 않으며, 적응형 시스템은 실수로부터 학습하여 반복을 피할 수 있습니다.
SambaNova는 어떻게 Nvidia를 능가한다고 주장하나요? SambaNova는 자사의 칩이 동일한 모델에서 Nvidia Blackwell GPU보다 추론 성능(와트당)이 2~3배 뛰어나다고 주장하며, 대규모 AI 워크로드의 총 소유 비용을 낮출 수 있다고 합니다.
가장 큰 모델은 사라질까요? 아니요. Hooker와 Liang 모두 대규모 모델은 최첨단 연구와 복잡한 작업에 여전히 중요할 것으로 예상합니다. 하지만 일상적인 애플리케이션에는 더 작고 효율적인 모델이 보완적으로 사용될 것입니다.
적응형 모델이 주류가 되려면 얼마나 걸릴까요? Adaption과 다른 스타트업들이 지속적 학습 아키텍처를 연구 중이지만, Hooker는 현재를 '변곡점'으로 설명했습니다. 인프라와 비즈니스 모델이 조정됨에 따라 광범위한 채택까지 2~4년이 걸릴 수 있습니다.
클라우드 AI 비용에 어떤 영향을 미칠까요? 적응형 모델이 중복 API 호출과 비효율적인 컴퓨팅 사용을 줄이면 기업의 AI 비용이 크게 낮아질 수 있습니다. 하지만 실시간 모델 업데이트와 추론 하드웨어에서 새로운 비용이 발생할 수 있습니다.
결론
AI 업계는 전환점에 서 있다. 컴퓨팅이 허용하는 한 빠르게 모델을 확장해온 세월 끝에, 이제 대화는 순수한 지능이 아닌 지속 가능성, 비용, 적응성으로 옮겨가고 있다. Hooker와 Liang과 같은 선도자들은 차세대 AI 가치 창출이 더 저렴하고, 시간이 지날수록 더 똑똑해지며, 특정 문제에 맞춰진 시스템에서 나올 것이라고 확신한다. 칩 효율성이나 모델 아키텍처로 측정하든, '클수록 좋다'의 시대는 더 미묘한 무언가, 즉 배포 가능하고, 저렴하고, 적응형인 AI로 자리 잡고 있다.
2026 Robot Overflow. 모든 권리 보유