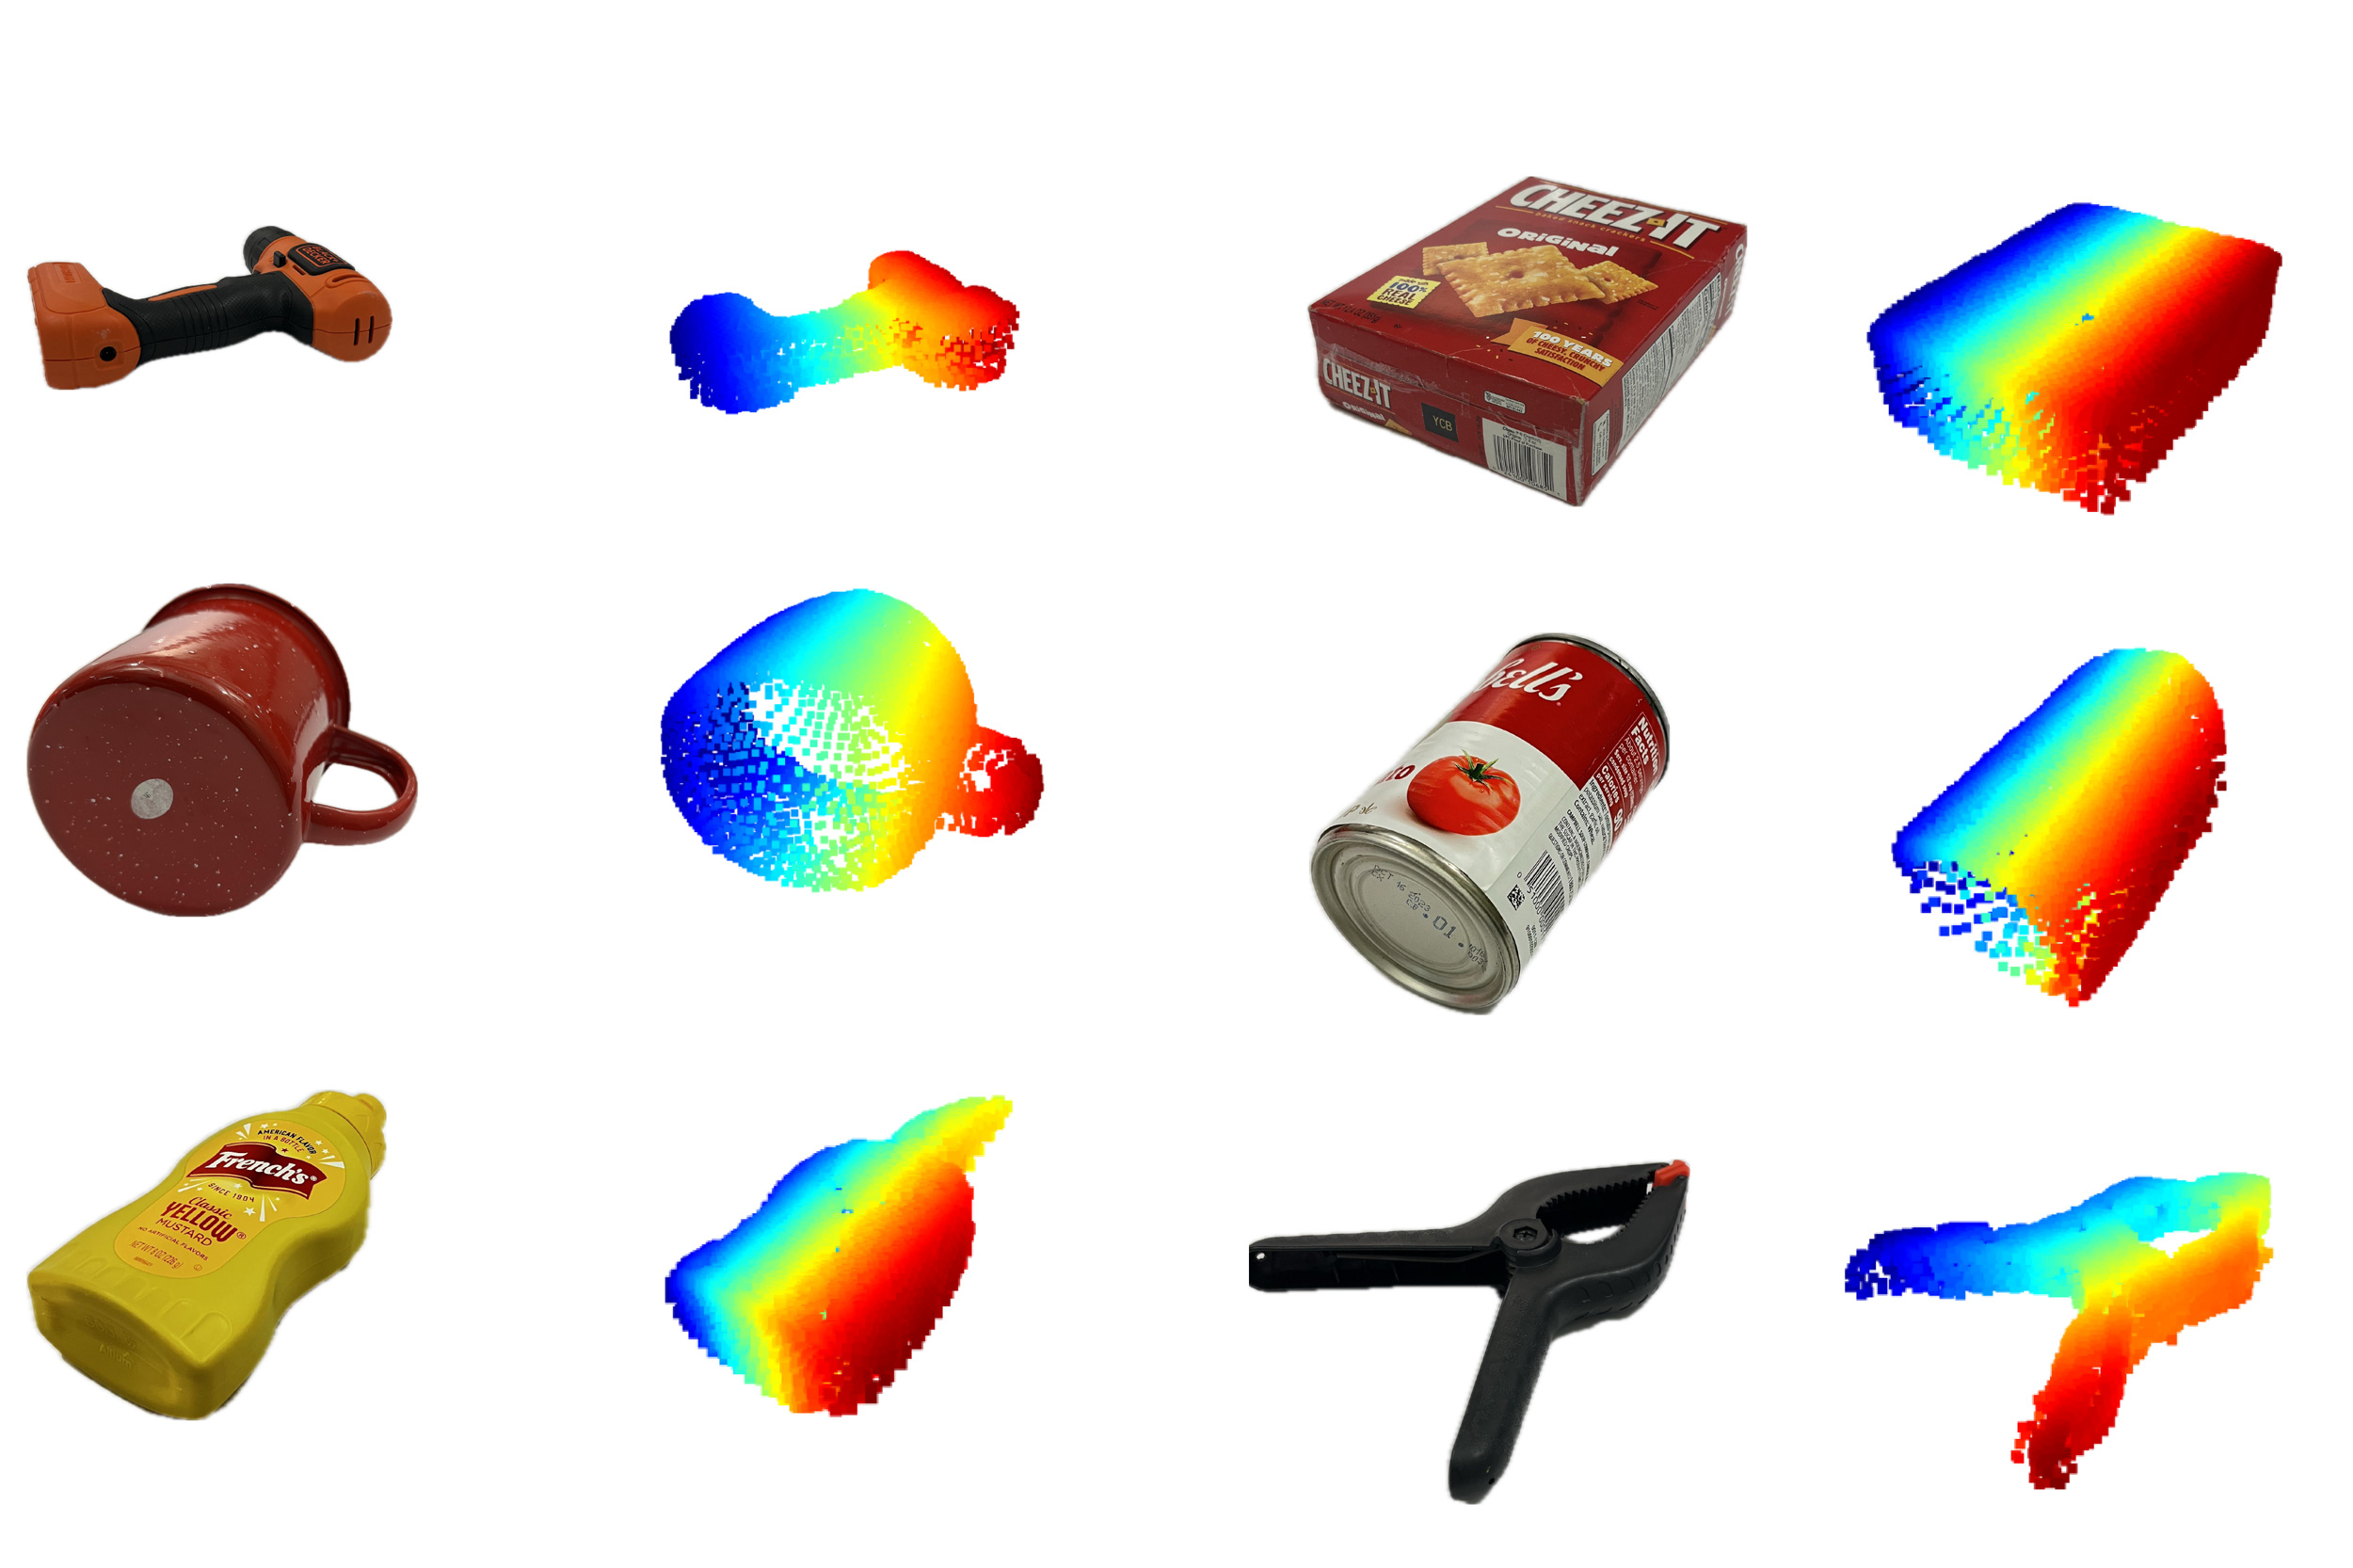
MIT शोधकर्ताओं ने विशेष रूप से प्रशिक्षित जनरेटिव AI मॉडल का उपयोग करके एक ऐसी प्रणाली बनाई जो छिपी 3D वस्तुओं के आकार को पूरा कर सकती है। क्रेडिट: शोधकर्ताओं के सौजन्य से।
वेयरहाउस और स्मार्ट होम में काम करने वाले रोबोटों की एक बुनियादी समस्या है: जो कुछ भी उनके कैमरों से अवरुद्ध है, वह उनके लिए अस्तित्व में ही नहीं है। MIT के शोधकर्ताओं ने अब जनरेटिव AI का उपयोग करके इसे ठीक किया है, जिसमें मिलीमीटर-वेव वायरलेस सिग्नल और विशेष रूप से प्रशिक्षित AI मॉडल का उपयोग करके छिपी वस्तुओं और पूरे कमरों को पिछले तरीकों की तुलना में लगभग 20% अधिक सटीकता के साथ पुनर्निर्मित किया जाता है—बिना एक भी कैमरे के।
- कैमरा-आधारित रोबोट विज़न में संरचनात्मक कमज़ोरी क्यों है
- Wave-Former दीवारों के पार छिपी वस्तुओं का पुनर्निर्माण कैसे करता है
- RISE: एकल रडार से पूरे कमरे का मानचित्रण
- प्रशिक्षण डेटा की समस्या—और MIT ने इसे कैसे हल किया
- वेयरहाउस और औद्योगिक रोबोटिक्स के लिए इसका क्या अर्थ है
- अक्सर पूछे जाने वाले प्रश्न
कैमरा-आधारित रोबोट विज़न में संरचनात्मक कमज़ोरी क्यों है
कैमरा-निर्भर रोबोट धारणा उस समय विफल हो जाती है जब कोई वस्तु दृश्य रेखा से बाहर हो जाती है—पैकेजिंग के पीछे, मलबे के नीचे, या कोने के आसपास। यह कोई किनारे का मामला नहीं है; यह वेयरहाउस, लॉजिस्टिक्स हब और घरेलू वातावरण में एक दैनिक परिचालन वास्तविकता है जहाँ रोबोट को उन वस्तुओं का पता लगाने, पहचानने और पकड़ने की आवश्यकता होती है जिन्हें वे सीधे नहीं देख सकते।
मौजूदा वैकल्पिक उपायों—एकाधिक कैमरे, संरचित प्रकाश, LiDAR—सभी में एक ही सीमा है: उन्हें एक स्पष्ट ऑप्टिकल पथ की आवश्यकता होती है। जैसे ही कार्डबोर्ड, ड्राईवॉल, प्लास्टिक, या घने कपड़े समीकरण में प्रवेश करते हैं, रोबोट प्रभावी रूप से अंधा हो जाता है। यह सीमा पूर्ति संचालन में महंगी त्रुटियाँ पैदा करती है, जिसमें गलत पहचाने गए पैक किए गए आइटम और विफल ग्रैस्प शामिल हैं जो उत्पादन लाइनों को रोक देते हैं।
MIT सिग्नल काइनेटिक्स समूह, जिसका नेतृत्व एसोसिएट प्रोफेसर फादेल अदीब करते हैं, ने एक दशक से अधिक समय विकल्प बनाने में बिताया है जिसमें मिलीमीटर-वेव (mmWave) रडार सिग्नल का उपयोग किया जाता है—वही आवृत्ति बैंड जो आधुनिक वाई-फ़ाई में उपयोग होता है—जो सामान्य अवरोधों से गुज़रते हैं और छिपी वस्तुओं से परावर्तित होते हैं। चुनौती, अब तक, यह थी कि ये परावर्तन सटीक हेरफेर के लिए उपयोगी होने के लिए बहुत अपूर्ण थे।
Wave-Former दीवारों के पार छिपी वस्तुओं का पुनर्निर्माण कैसे करता है
Wave-Former, MIT की नई प्रणाली, mmWave रडार को एक जनरेटिव AI मॉडल के साथ जोड़ती है ताकि अवरोधों के पीछे छिपी वस्तुओं के पूर्ण 3D आकार का पुनर्निर्माण किया जा सके—जो लगभग 70 रोज़मर्रा की वस्तुओं (डिब्बे, बक्से, बर्तन, फल) में पिछले सर्वश्रेष्ठ तरीकों की तुलना में लगभग 20% सटीकता सुधार प्राप्त करता है।
मुख्य भौतिकी समस्या स्पेक्युलैरिटी है: mmWave सिग्नल सतहों से एक ही दिशा में परावर्तित होते हैं, जैसे दर्पण से प्रकाश। रडार सेंसर केवल उन्हीं परावर्तनों को कैप्चर करता है जो उसकी ओर वापस निर्देशित होते हैं, जिसका अर्थ है कि छिपी वस्तु की ऊपरी सतह आंशिक रूप से दिखाई देती है जबकि उसके किनारे और निचला भाग प्रभावी रूप से अदृश्य होते हैं। पिछली प्रणालियों ने इन अपूर्ण बिंदु बादलों की व्याख्या करने के लिए अकेले भौतिकी-आधारित नियमों का उपयोग करने की कोशिश की—एक मौलिक रूप से सीमित दृष्टिकोण।
Wave-Former की पाइपलाइन तीन चरणों में काम करती है। पहला, यह कच्चे mmWave परावर्तनों से छिपी वस्तु का आंशिक पुनर्निर्माण करती है। दूसरा, यह आंशिक आकार को एक जनरेटिव AI मॉडल को खिलाती है जो प्रशिक्षित है कि वह आकार का संभावित पूरा होना भविष्यवाणी कर सके। तीसरा, यह सतह को बार-बार परिष्कृत करती है जब तक कि यह पूर्ण 3D पुनर्निर्माण पर केंद्रित न हो जाए। परिणाम: रोबोट न केवल छिपी वस्तु का पता लगा सकते हैं, बल्कि उसकी ज्यामिति को भी समझ सकते हैं ताकि एक विश्वसनीय ग्रैस्प की योजना बना सकें।
रोबोहब के शोध कवरेज के अनुसार, इस प्रणाली को कार्डबोर्ड, लकड़ी, ड्राईवॉल, प्लास्टिक और कपड़े के पीछे या नीचे छिपी वस्तुओं पर मान्य किया गया—वे सामग्री जो वास्तविक वेयरहाउस और लॉजिस्टिक्स वातावरण में मौजूद हैं।
RISE: एकल रडार से पूरे कमरे का मानचित्रण
MIT की दूसरी प्रणाली, RISE (Radar-based Indoor Scene Understanding), एक स्थिर mmWave रडार से परावर्तनों का उपयोग करके पूरे कमरे के लेआउट—जिसमें फर्नीचर की नियुक्ति शामिल है—का पुनर्निर्माण करती है। यह मौजूदा तकनीकों की तुलना में लगभग दोगुनी स्थानिक सटीकता प्राप्त करती है और इसके लिए किसी मोबाइल सेंसर प्लेटफॉर्म की आवश्यकता नहीं है।
वर्तमान में अधिकांश वायरलेस दृश्य पुनर्निर्माण दृष्टिकोणों को पर्यावरण को स्कैन करने के लिए एक रडार की आवश्यकता होती है जो एक गतिमान रोबोट पर लगा हो—एक महत्वपूर्ण परिचालन बाधा। RISE एक अलग दृष्टिकोण अपनाता है: यह एक कमरे में प्राकृतिक रूप से घूमने वाले मनुष्यों द्वारा उत्पन्न मल्टीपथ परावर्तनों का शोषण करता है।
जब कोई व्यक्ति चलता है, तो mmWave सिग्नल उससे टकराते हैं, फिर दीवारों और फर्नीचर से परावर्तित होकर रडार पर लौटते हैं। ये द्वितीयक प्रतिध्वनियाँ—जिन्हें आमतौर पर "घोस्ट सिग्नल" के लेबल के तहत शोर के रूप में त्याग दिया जाता है—वास्तव में कमरे के लेआउट के बारे में स्थानिक जानकारी को एनकोड करती हैं। जैसे-जैसे व्यक्ति चलता है, घोस्ट सिग्नल बदलते हैं, और उनकी बदलती स्थितियाँ आसपास की सतहों की ज्यामिति को प्रकट करती हैं।
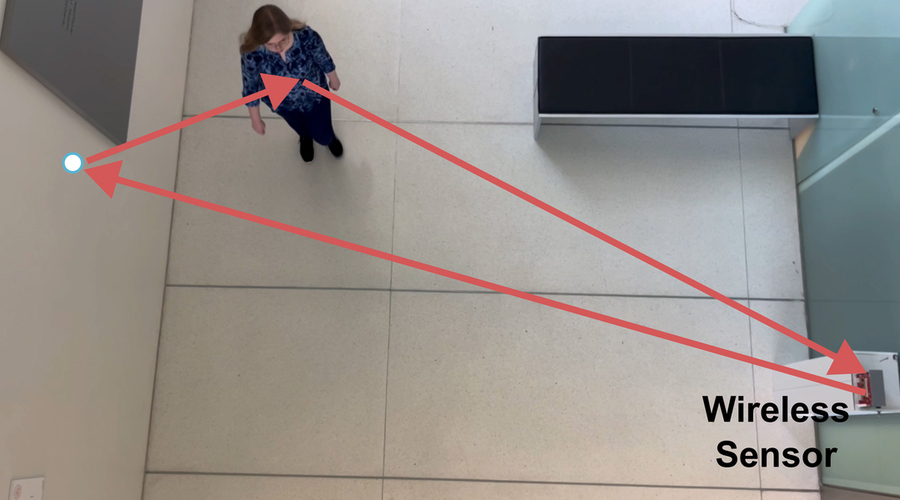 टीम ने एक विस्तारित प्रणाली भी बनाई जो एक कमरे में घूमने वाले मनुष्यों से वायरलेस सिग्नल परावर्तनों का लाभ उठाकर पूरे इनडोर दृश्यों का पुनर्निर्माण करती है। क्रेडिट: शोधकर्ताओं के सौजन्य से।
RISE को एक स्थिर रडार द्वारा कैप्चर किए गए 100 से अधिक मानव प्रक्षेपवक्र पर मान्य किया गया। गोपनीयता का निहितार्थ भी उल्लेखनीय है: कैमरा प्रणालियों के विपरीत, mmWave रडार व्यक्तियों की दृश्य छवियाँ कैप्चर नहीं करता, जिससे इसे उन वातावरणों में तैनात किया जा सकता है जहाँ कैमरों के सामने नियामक या सहमति संबंधी बाधाएँ हों।
प्रशिक्षण डेटा की समस्या—और MIT ने इसे कैसे हल किया
इस क्षेत्र में किसी भी AI मॉडल के लिए मूल बाधा डेटा की कमी है: कोई भी mmWave डेटासेट इतना बड़ा नहीं है कि एक जनरेटिव मॉडल को शुरू से प्रशिक्षित किया जा सके। MIT का समाधान मौजूदा बड़े पैमाने के कंप्यूटर विज़न डेटासेट के शीर्ष पर mmWave भौतिकी का अनुकरण करना था—प्रभावी रूप से AI को रडार-विशिष्ट प्रशिक्षण डेटा की आवश्यकता के बिना रडार की भाषा सिखाना।
GPT या Claude जैसे बड़े जनरेटिव मॉडल को प्रशिक्षित करने के लिए लाखों या अरबों उदाहरणों वाले डेटासेट की आवश्यकता होती है। mmWave शोध डेटासेट आकार में कई गुना छोटे होते हैं। पर्याप्त वास्तविक दुनिया का रडार डेटा एकत्र करने में, MIT की शोध सहायक मैसी लैम बताती हैं, "वर्षों लग जाते".
टीम का वर्कअराउंड सिंथेटिक अनुकूलन था: उन्होंने मौजूदा बड़े कंप्यूटर विज़न डेटासेट लिए और उन पर mmWave परावर्तनों के भौतिक गुणों—स्पेक्युलैरिटी, शोर विशेषताएँ, सिग्नल ज्यामिति—को संगणनात्मक रूप से लागू किया। इसने एक सिंथेटिक लेकिन भौतिक रूप से सटीक प्रशिक्षण सेट बनाया जिससे जनरेटिव मॉडल सीख सके।
यह दृष्टिकोण फिजिकल AI अनुसंधान में उभरते हुए एक व्यापक पैटर्न का प्रतिनिधित्व करता है: भौतिकी-सूचित सिमुलेशन का उपयोग करके AI प्रशिक्षण को बढ़ावा देना जहाँ वास्तविक दुनिया का डेटा दुर्लभ या महंगा है। यही सिद्धांत रोबोट मैनिपुलेशन लर्निंग में अधिकांश प्रगति को रेखांकित करता है, जहाँ सिम-टू-रियल ट्रांसफर एक प्रमुख प्रतिमान बन गया है।
| सिस्टम | कार्य | सिग्नल स्रोत | सटीकता लाभ | सेंसर कॉन्फ़िगरेशन |
|---|---|---|---|---|
| Wave-Former | छिपी वस्तु 3D पुनर्निर्माण | वस्तुओं से mmWave परावर्तन | SOTA से ~20% अधिक | मोबाइल या फिक्स्ड रडार |
| RISE | पूरे कमरे का दृश्य पुनर्निर्माण | घूमते मनुष्यों से mmWave परावर्तन | SOTA से ~2× सटीकता | एकल स्थिर रडार |
वेयरहाउस और औद्योगिक रोबोटिक्स के लिए इसका क्या अर्थ है
रोबोटिक्स खरीदारों और इंजीनियरों के लिए, ये दो प्रणालियाँ अलग-अलग लेकिन समान रूप से दबावपूर्ण परिचालन समस्याओं का समाधान करती हैं: सीलबंद कंटेनरों में पैक किए गए आइटमों का सत्यापन करना, और रोबोट को पूर्ण सेंसर कवरेज के बिना गतिशील वातावरण को समझने में सक्षम बनाना।
पूर्ति और पैक सत्यापन
वेयरहाउस रोबोट वर्तमान में यह पुष्टि नहीं कर सकते कि एक सीलबंद बक्से के अंदर क्या है, बिना उसे खोले। Wave-Former की कार्डबोर्ड और प्लास्टिक के माध्यम से 3D वस्तु ज्यामिति का पुनर्निर्माण करने की क्षमता सीधे प्री-शिपमेंट सत्यापन को संबोधित करती है—ई-कॉमर्स पूर्ति के लिए एक महत्वपूर्ण समस्या, जहाँ गलत पैक किए गए ऑर्डर से रिटर्न दरें काफी लागत उत्पन्न करती हैं। एक रडार धारणा से सुसज्जित रोबोट बक्से को सील करने से पहले आइटम की उपस्थिति और मोटी ज्यामिति की पुष्टि कर सकता है, बिना लाइन को धीमा किए।
कोबोट्स और एएमआर के लिए स्मार्ट डिप्लॉयमेंट
RISE की एकल-रडार कक्ष मानचित्रण क्षमता का स्वायत्त मोबाइल रोबोटों (AMRs) और मनुष्यों के साथ साझा स्थानों में तैनात कोबोट्स के लिए तत्काल निहितार्थ है। वर्तमान मानव-ट्रैकिंग दृष्टिकोणों में या तो घने कैमरा कवरेज (जुड़े गोपनीयता मुद्दों के साथ) या स्वयं गतिमान रोबोट पर लगे सेंसर की आवश्यकता होती है। एक फिक्स्ड रडार जो भूत सिग्नल विश्लेषण से कमरे का एक जीवित स्थानिक मॉडल बनाता है—जिसमें मानव स्थान शामिल हैं—गतिशील वातावरण में सुरक्षित, अधिक उत्तरदायी कोबोट संचालन को सक्षम कर सकता है।
इन अनुप्रयोगों के लिए रोबोट का मूल्यांकन करने वाली टीमों के लिए, Robot Overflow पर उपलब्ध प्रयुक्त औद्योगिक रोबोट और कोबोट्स को देखना उचित है, जबकि Wave-Former जैसी धारणा प्रणालियाँ व्यावसायिक एकीकरण की ओर बढ़ रही हैं।
तैनाती की समयरेखा
दोनों प्रणालियाँ अनुसंधान चरण में हैं, जिनके परिणाम IEEE कॉन्फ्रेंस ऑन कंप्यूटर विज़न एंड पैटर्न रिकॉग्निशन में प्रस्तुत किए जाएँगे। शोध को NSF, MIT मीडिया लैब और Amazon द्वारा समर्थित किया गया है—बाद वाला व्यावसायिक रुचि का एक महत्वपूर्ण संकेत है। टीम का अगला कथित लक्ष्य वायरलेस सिग्नलों के लिए फाउंडेशन मॉडल बनाना है, जो भाषा के लिए GPT या Gemini के अनुरूप है, जो पर्यावरणों और वस्तु प्रकारों में इस दृष्टिकोण की सामान्यीकरण क्षमता में एक चरण-परिवर्तन का प्रतिनिधित्व करेगा।
अक्सर पूछे जाने वाले प्रश्न
Wave-Former क्या है और यह कैसे काम करता है?
Wave-Former MIT द्वारा विकसित एक प्रणाली है जो मिलीमीटर-वेव (mmWave) रडार सिग्नलों का उपयोग करके कार्डबोर्ड, ड्राईवॉल और प्लास्टिक जैसी बाधाओं के पीछे छिपी वस्तुओं के 3D आकार का पुनर्निर्माण करती है। यह रडार परावर्तनों से एक आंशिक पुनर्निर्माण बनाती है, फिर लापता ज्यामिति को पूरा करने के लिए एक जनरेटिव AI मॉडल का उपयोग करती है। लगभग 70 रोज़मर्रा की वस्तुओं के परीक्षण में, इसने पिछले सर्वश्रेष्ठ तरीकों की तुलना में लगभग 20% बेहतर सटीकता प्राप्त की।
RISE बिना कैमरों के कमरों का पुनर्निर्माण कैसे करता है?
RISE एक स्थिर mmWave रडार का उपयोग करता है और "भूत सिग्नलों" का शोषण करता है—द्वितीयक परावर्तन जो एक कमरे में घूमने वाले मनुष्यों से टकराते हैं और फिर आसपास के फर्नीचर और दीवारों से परावर्तित होते हैं। जैसे-जैसे व्यक्ति चलता है, इन मल्टीपथ परावर्तनों में परिवर्तन को ट्रैक करके, एक जनरेटिव AI मॉडल पूरे कमरे के स्थानिक लेआउट का अनुमान लगाता है। RISE ने 100 से अधिक परीक्षण प्रक्षेपवक्रों में मौजूदा वायरलेस दृश्य पुनर्निर्माण तकनीकों की तुलना में लगभग दोगुनी स्थानिक सटीकता प्रदर्शित की।
mmWave सिग्नल किन बाधाओं को भेद सकते हैं?
मिलीमीटर-वेव सिग्नल—जो वाई-फ़ाई के समान आवृत्ति रेंज में हैं—सामान्य गैर-धात्विक सामग्रियों जैसे कार्डबोर्ड, लकड़ी, ड्राईवॉल, प्लास्टिक और कपड़े से गुज़रते हैं। वे धातु को प्रभावी रूप से भेद नहीं पाते। यह उन्हें वेयरहाउस वातावरण के लिए उपयुक्त बनाता है जहाँ सामान कार्डबोर्ड और प्लास्टिक में पैक किया जाता है, लेकिन भारी धातु औद्योगिक संलग्नकों में कम लागू होता है।
क्या यह तकनीक कैमरों की तुलना में गोपनीयता को बेहतर संरक्षित करती है?
हाँ। mmWave रडार पर्यावरण में लोगों की दृश्य छवियाँ कैप्चर नहीं करता—यह केवल सिग्नल परावर्तनों का पता लगाता है। RISE की कक्ष-मानचित्रण क्षमता किसी भी पहचान योग्य दृश्य डेटा को रिकॉर्ड किए बिना एक सिग्नल स्रोत के रूप में मानव गति का उपयोग करती है, जो इसे गोपनीयता-संवेदनशील तैनाती जैसे अस्पतालों, घरों या विनियमित कार्यस्थलों में कैमरा-आधारित स्थानिक मानचित्रण पर एक सार्थक लाभ देती है।
यह तकनीक व्यावसायिक रोबोटों में कब उपलब्ध होगी?
Wave-Former और RISE दोनों वर्तमान में अनुसंधान चरण में हैं, जिनके पेपर CVPR में प्रस्तुत किए जाएँगे। Amazon वित्त पोषण भागीदारों में से एक है, जो सक्रिय व्यावसायिक रुचि का सुझाव देता है। MIT टीम ने संकेत दिया है कि वायरलेस सिग्नल फाउंडेशन मॉडल बनाना अगला विकास प्राथमिकता है। वेयरहाउस या कोबोट सिस्टम में व्यावसायिक एकीकरण संभवतः वर्षों दूर है, लेकिन तैनात करने योग्य हार्डवेयर की ओर प्रक्षेपवक्र स्पष्ट है।
यह शोध पिछले वर्ष के सबसे व्यावहारिक रूप से आधारित रोबोट धारणा प्रगति में से एक का प्रतिनिधित्व करता है—यह कोई मामूली बेंचमार्क सुधार नहीं है, बल्कि एक वास्तविक वास्तुशिल्प बदलाव है कि रोबोट अपने आसपास की दुनिया को कैसे मॉडल कर सकते हैं। जनरेटिव AI अब केवल एक भाषा या छवि उपकरण नहीं है; यह वह अनुमान इंजन बन रहा है जो भौतिक प्रणालियों को उस चीज़ के बारे में तर्क करने देता है जो वे सीधे नहीं देख सकते।