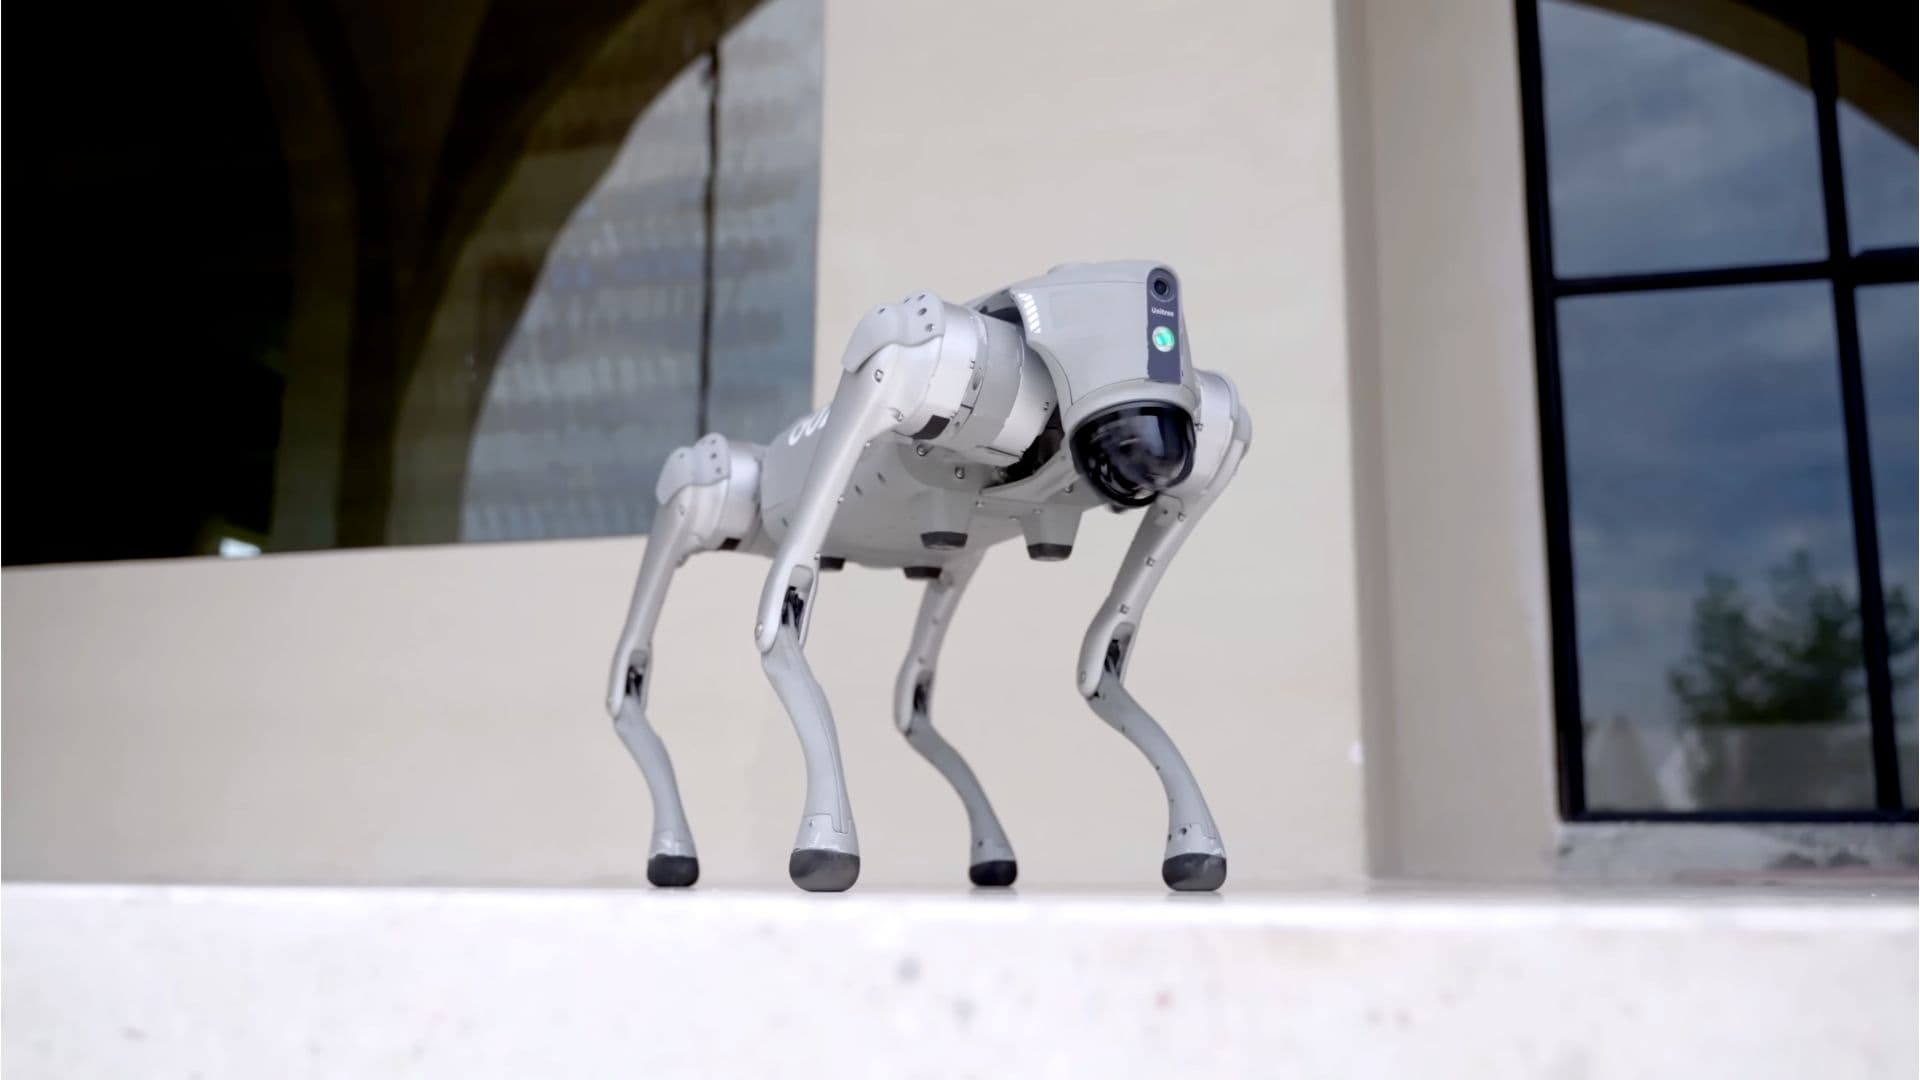
研究人员训练出一个四足机器人策略,使其能够执行 22 项任务。这项研究最初由 Arxiv 报道。该策略掌握了行走、挖掘和跳跃等技能,并能将这些技能组合起来,形成爬行等新行为;研究人员还将训练得到的策略部署到了 Unitree B1 四足机器人上。
整个流程从多个教师策略开始,每个策略都通过强化学习针对一项范围明确的任务进行训练。接下来的两个阶段采用多教师蒸馏,利用这些教师策略训练学生策略,并结合强化学习与模仿学习目标。对抗式任务选择则将训练重点引向表现最差的任务。
强化学习已让足式机器人能够在单任务场景中完成多种技能,但农用机器人和太空探索等应用需要机器人具备多样化能力,包括运动、挖掘和近距离勘测。样本利用效率低下,以及不同任务间的梯度冲突,都让端到端多任务训练变得困难。
评估结果显示,与 PPO 和先蒸馏后微调的基线方法相比,该方法保留了动作质量,并能更准确地跟踪指令。在某些情况下,学生策略无需针对新任务进行专门训练,也能泛化到这些任务。
该方法将丰富的任务技能集中到一个学生策略中,同时让每个教师策略专注于一项范围明确的任务。研究人员将最终策略部署到 Unitree B1 四足机器人上,以验证其在真实环境中的鲁棒性。