教会机器人新的操作技能通常需要数百小时的任务特定数据。研究人员提出的一种新框架表明,机器人可以从仅五次示范中学习可复用的奖励函数——并将其零样本泛化到全新的位置、物体和视角,无需重新训练。这一突破可能通过消除机器人强化学习中的一个主要瓶颈,极大加速机器人在工厂和仓库中的实际部署。
为什么真实世界的机器人奖励函数会失败?
奖励函数定义了机器人在强化学习中应达成的目标,但传统的基于视觉的奖励记住的是特定像素模式,而非任务的根本目标。当相机角度改变、物体变化或光照不同时,这些奖励就会失效——迫使工程师为每个环境手动重新设计。
研究人员在发布于arXiv的预印本中指出,“基于视觉的奖励模型倾向于记住特定的像素分布,无法泛化到训练条件之外。”这种过拟合是开放世界操作问题中的根本挑战,其中单个任务可能通过不同的物体实例、位置和相机视角呈现出无数变体。一个被训练识别白色桌子上红色杯子的奖励,在杯子变成蓝色、桌子变成木质或机器人从对面接近时就会失效。这种脆弱性的代价高昂:每个新的部署环境实际上都需要一个新的奖励工程周期,限制了可扩展性。
不变奖励框架是如何工作的?
该框架从拟合视觉特征转向发现行为不变性:即在多样的视觉实例中保持恒定的任务级属性。它使用两个耦合组件——一个结构化的奖励公式,编码任务策略和物理约束,同时保持最优策略不变性;以及一个混合符号-数值过程,从示范中提取这些不变性,无需任何在线交互。
可以将其理解为教会机器人谜题的逻辑而非拼图的具体颜色——这样它就能解决任何变体。与端到端的神经奖励模型学习像素与成功之间的相关性不同,这种方法显式搜索在视觉变换下成立的有符号规则。混合过程首先从示范中提取候选符号谓词,然后根据物理一致性约束进行验证。结果是一个以物体关系和几何而非原始图像特征表达的奖励函数。不过,这个类比并不完全准确:框架保留了数值组件以实现精细控制;它不是纯符号的,而是使用符号来指导数值奖励的计算。
实验展示了哪些结果?
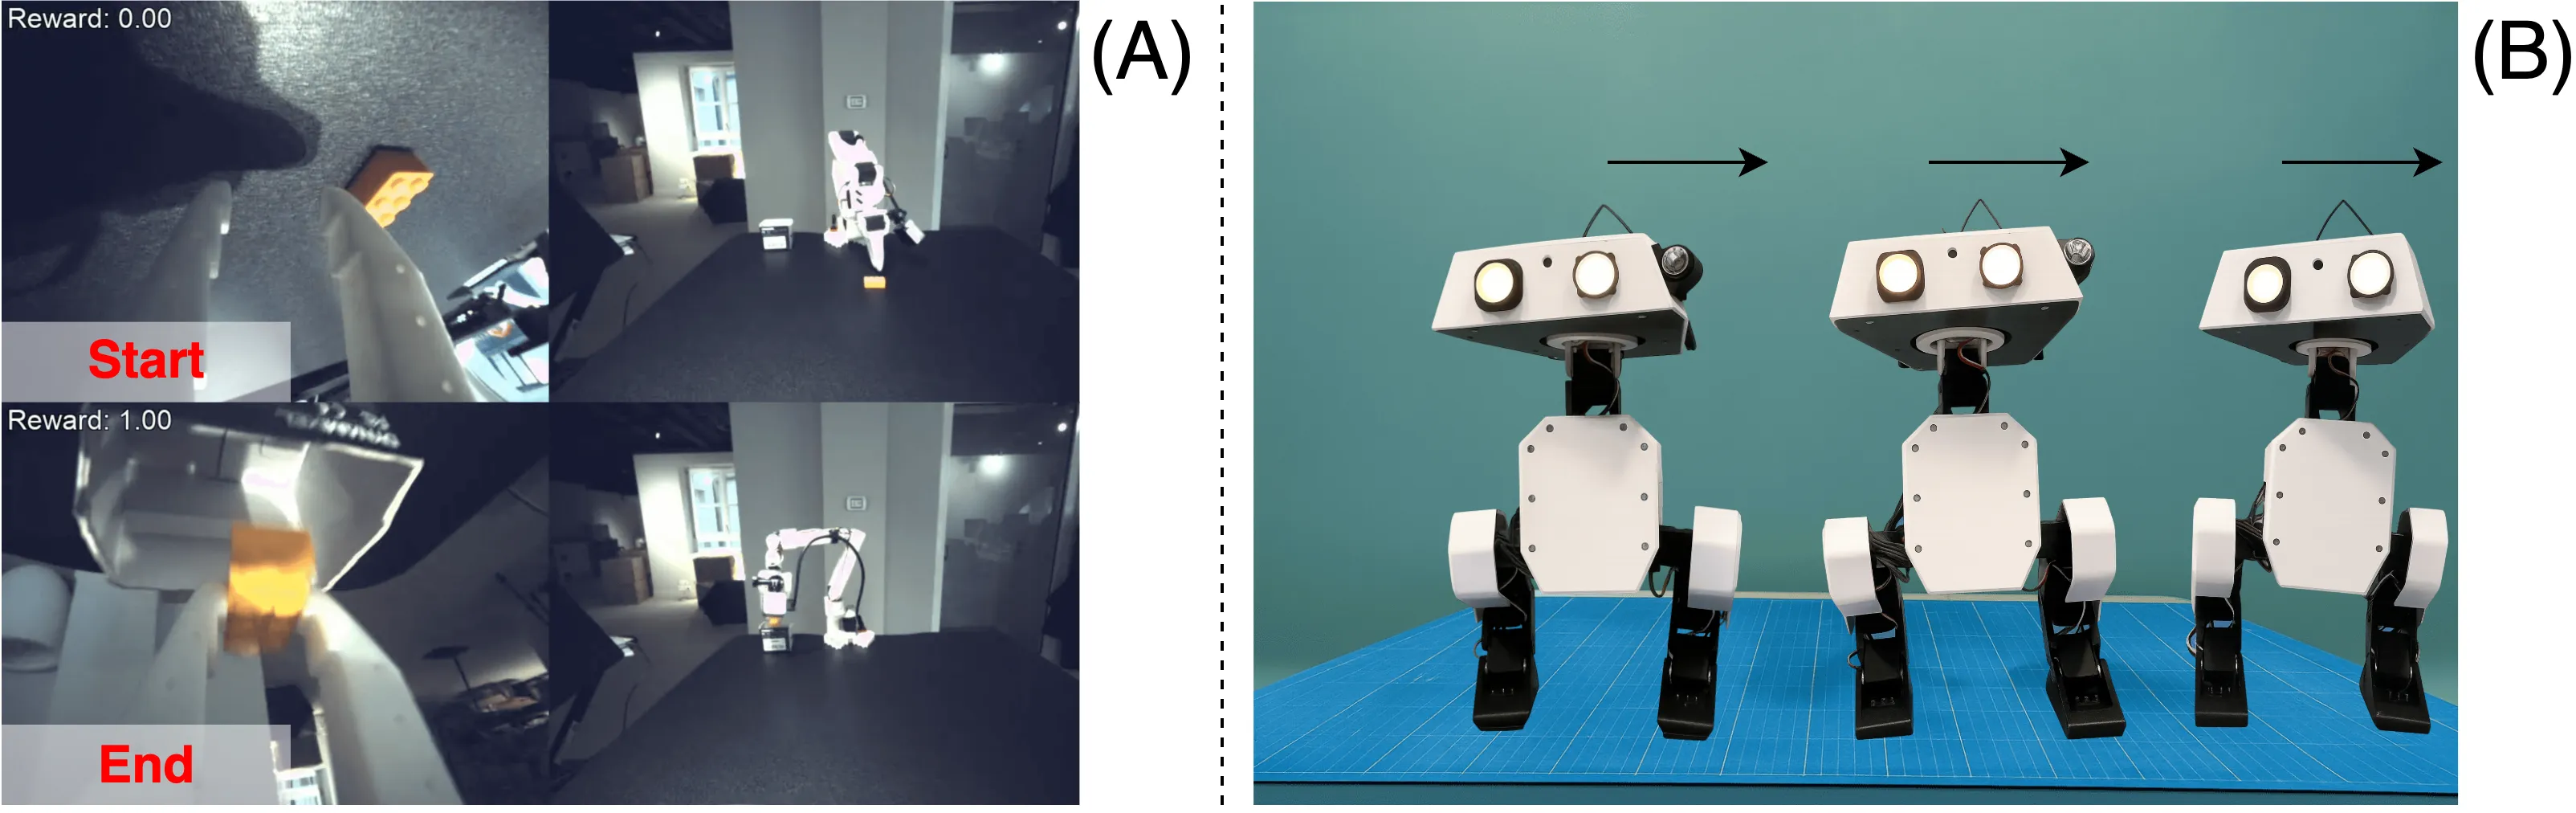
该方法在八个Meta-World操作任务和三个Franka真实机器人任务上进行了测试。它在过程对齐和策略滚动排名上优于基线方法。在真实世界的分布外测试中,相同的学习奖励零样本泛化到了位置、视角和物体外观的变化——作者称这一结果使得“单个奖励表示在实践中能够跨多样任务变体重用。”
| 方法 | 所需数据 | 泛化能力 | 真实世界分布外 |
|---|---|---|---|
| 传统奖励学习 | 100+次示范 | 差 | 未展示 |
| 不变奖励框架 | 5次示范 | 零样本位置/视角/物体 | 在3个实验中展示 |
| 基线视觉模型 | 50+次示范 | 有限(微小视角变化) | 在分布外失败 |
零样本能力尤其重要:在实验室设置中使用单一物体实例学习的奖励,直接迁移到了新物体形状、不同桌子高度和从未遇到的光照条件。作者指出,“相同的学习奖励零样本泛化到位置、视角和物体变化”,这直接解决了在生产线环境中部署强化学习的最大障碍之一。
这如何加速下游策略学习?
通过提供稳定且可泛化的奖励信号,该框架使下游强化学习策略能够更快学习并跨任务迁移。不变奖励缩小了策略的搜索空间,使其专注于运动控制,而不是为每个变体重学任务目标。
在传统设置中,机器人必须针对每个新的物体位置或相机放置重新训练——每个变体实际上都变成了一个新任务。使用不变奖励,策略可以训练一次,然后使用相同的奖励函数针对特定环境进行微调。实验显示了更强的过程对齐,意味着策略不仅达成了目标,而且通过模仿示范行为的方式。对于机器人集成商来说,这转化为减少的工程时间:无需为每个工作站花费数周进行奖励调优,而是可以从少量人类示范中学习一个通用奖励,然后应用于整个生产线。
零样本泛化对机器人意味着什么?
零样本泛化意味着机器人可以拿起从未见过的物体,到达从未到达过的位置,在从未经历的光照条件下——使用仅从五次初始示范中学到的相同奖励函数。这是开放世界操作的关键能力,其中每个环境都是独特的。
对于仓库自动化,这可能意味着单个机器人手臂可以处理任意大小和放置的进箱包裹,无需预先校准。在制造业中,协作机器人可以从五次操作员示范中学习新的装配步骤,然后在任何工作台布局上执行。研究人员正是展示了这一点:他们的真实世界分布外实验包括将目标物体在工作空间内移动,将相机旋转到全新角度,以及将物体换成不同形状和颜色的物体——所有这些都由相同的学习奖励处理。对部署成本的影响是巨大的:不再需要支付系统集成商进行特定于站点的奖励工程,最终用户可以直接获得一个能即时适应的预训练奖励。
这对机器人的意义
对于评估用于操作的强化学习的机器人团队来说,该框架直接解决了数据效率和泛化问题,这些问题一直阻碍着基于强化学习的自动化在大多数商业部署中的普及。从五次示范而不是数百次中学习的能力,降低了中小企业进入的门槛。此外,零样本泛化意味着单个奖励可以在多个工作站之间共享,降低了总拥有成本。
对于考虑在Robot Overflow上购买二手协作机器人或二手工业机器人的买家来说,这项研究指向了一个未来:机器人变得更适应,无需昂贵的定制编程。虽然该框架仍处于研究阶段,但其极低的数据需求和验证过的真实世界分布外性能表明,包含类似想法的商业工具包可能在一到两年内出现。机器人专家应关注混合符号-数值方法,将其作为纯神经奖励模型的潜在替代方案。
常见问题
需要多少次示范? 该框架只需五次示范即可工作。实验使用五次人类提供的示范来学习零样本泛化的不变奖励函数。
是否需要模拟器? 奖励学习步骤不需要在线交互或模拟器。混合符号-数值过程仅从提供的示范中提取不变性。下游策略学习可以使用模拟器或真实世界滚动。
测试了哪些类型的任务? 该方法在八个Meta-World基准任务(包括推、抓取和装配)以及三个Franka Emika真实机器人操作任务(涉及拾取和放置以及插销插入)上进行了评估。
能否与不同的机器人手臂配合使用? 该框架与手臂无关。它学习任务级不变性,独立于机器人的运动学,因此只要任务目标相同,相同的奖励可以在不同操作器之间迁移。
是否准备好商业部署? 该框架已在真实世界分布外实验中验证,但仍属于学术研究贡献。商业采用需要集成到标准的强化学习堆栈中,并在更广泛的任务上验证。
与模仿学习相比如何? 模仿学习复制示范的动作,但在新状态下表现不佳。该框架学习任务目标(奖励)而非策略,从而能够零样本迁移到新的状态分布,同时仍允许下游策略发现最优行为。
结论
仅从五次示范中学习不变奖励代表了向机器人可部署强化学习迈出的实际一步。通过从像素拟合转向行为不变性,该框架解决了限制基于视觉奖励在真实世界应用的泛化问题。随着机器人专家寻求降低自动化的数据和工程成本,这种方法提供了一条路径,使机器人真正理解任务——而不仅仅是它们被教授时的特定视觉条件。
你的部署瓶颈是奖励设计还是数据收集——不变奖励能否改变你的工作流程?