OpenAI、Google、Microsoft 和 Anthropic 表示,如果网站设置了出版商共享信号,它们将限制自家的 AI 爬虫访问该网站。据 The Verge 首先报道,这将为出版商提供一个统一入口,表明 AI 公司是否可以使用其网站内容进行训练,取代目前需要针对每家服务商分别管理的设置。
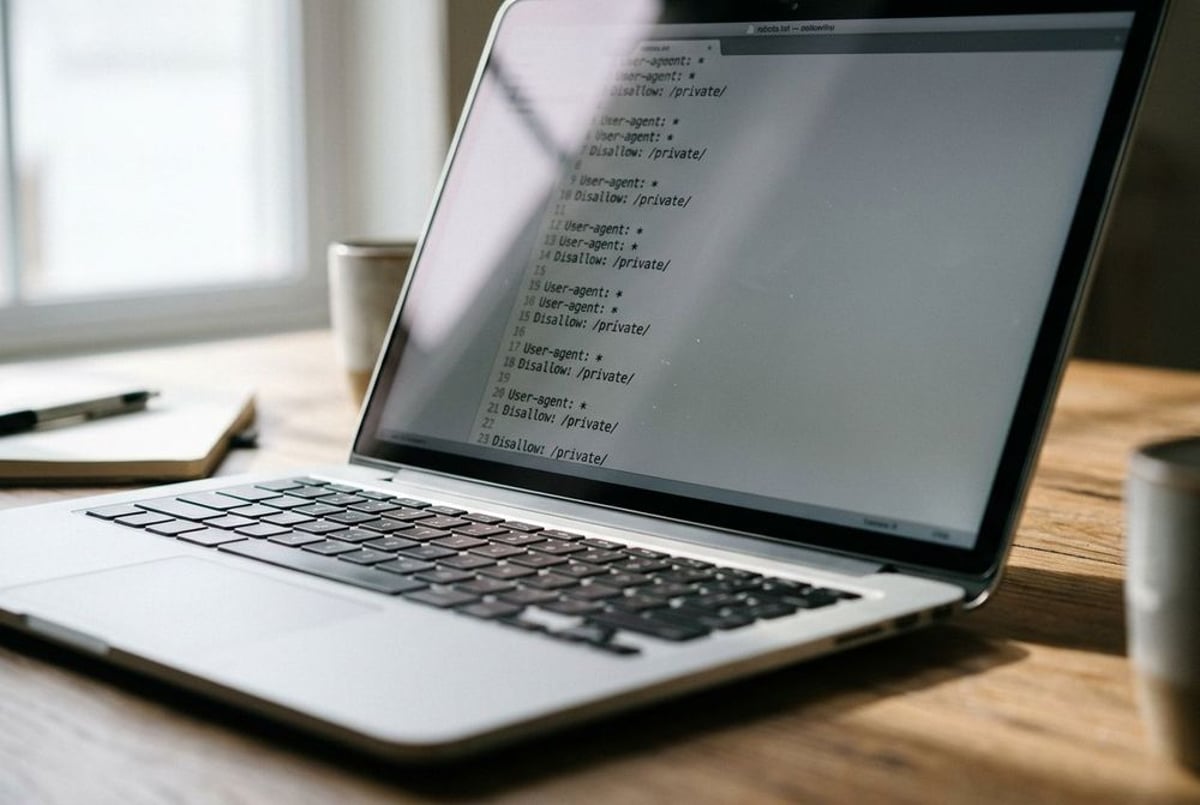
拟议中的“政策令牌”将写入网站的 robots.txt 文件。长期以来,该文件一直用于告知网络爬虫是否可以抓取网站,以便进行搜索索引、存档或 AI 训练。Anthropic 标准技术负责人 Kevin Kelley 在互联网工程任务组(IETF)提出了这一信号。
目前,出版商必须分别向各家公司表明自己对 AI 训练的偏好。四家公司表示,如果其 AI 爬虫发现这一共享令牌,就会限制爬虫访问相关网站,从而将原本分散的设置整合为一个信号。
随着 AI 爬虫持续涌入出版商网站并将内容输入模型,这项提案应运而生。其他相关举措包括 Really Simple Licensing(RSL)标准,允许出版商向访问其网站的爬虫收费,以及 Cloudflare 默认屏蔽 AI 爬虫的做法。
Microsoft 表示,将提供细化控制选项,让用户选择退出 AI 训练或 AI 事实锚定。后者是指将 AI 模型指向经过验证的信息来源,以减少幻觉。Microsoft 称,无论网站如何设置这些偏好,网站仍会出现在 Bing 搜索结果中;Google 也为 AI 搜索功能和训练提供了类似控制选项,且这些选项不会影响网站在搜索结果中的展示。这些例子表明,网站对 AI 使用内容的偏好与其在搜索结果中的呈现彼此独立。
Meta 传播负责人 Andy Stone 也表示支持采用通用设置,但没有说明 Meta 是否会遵循该设置。Anthropic 已采用这一信号;Google 和 Microsoft 计划明年支持,OpenAI 则表示将在未来几个月内实施。