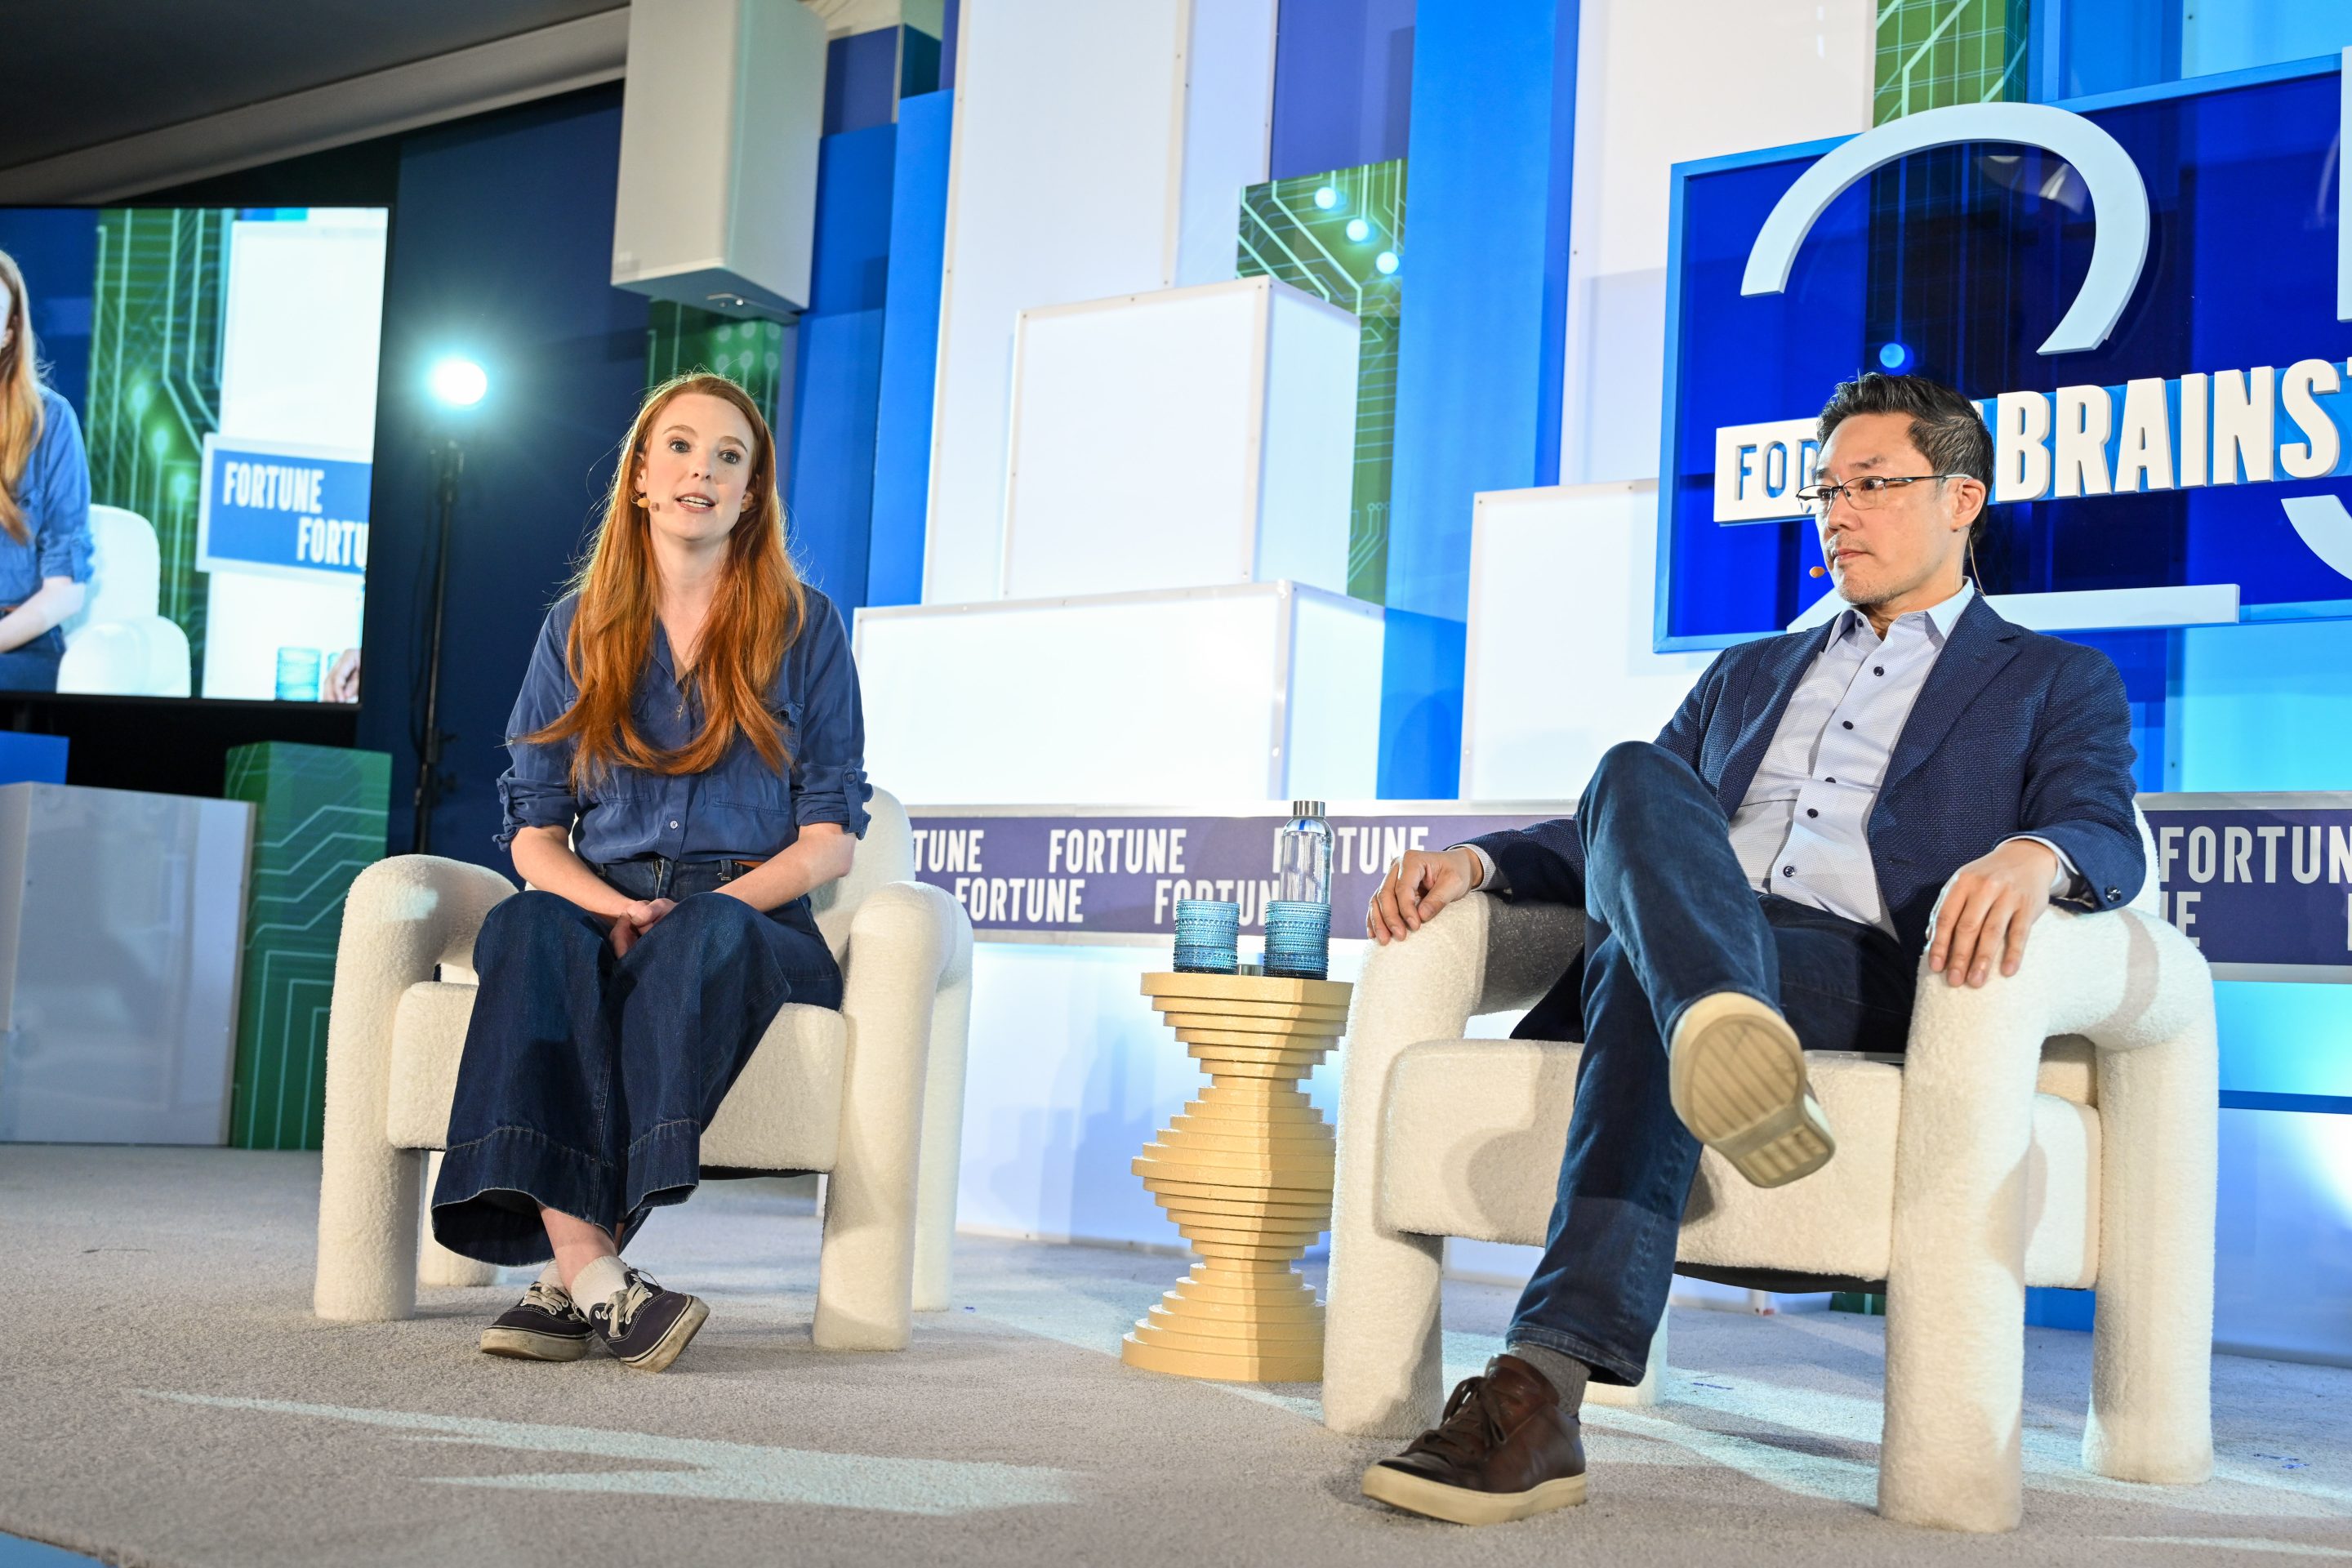
AI行业正从持续多年的“越大越好”狂热,转向让系统高效可大规模部署的紧迫任务。在Fortune Brainstorm Tech大会上,多位高管指出“巨无霸”模型的时代正在落幕,Adaption CEO Sara Hooker和SambaNova CEO Rodrigo Liang呼吁对AI构建与运行方式进行根本性变革。
巨无霸模型之困
过去几年,AI领域的主流叙事一直是“越大越好”。每个新模型的参数规模都冲向数千亿甚至万亿。但AI实验室Adaption的联合创始人兼CEO Sara Hooker指出,这种方法导致了根本性的效率低下。
“当前大多数AI都是巨无霸式的,固步自封,”她在大会上表示。“模型一旦训练完成,其知识和能力就基本固定了。如果世界发生变化,或者模型从用户那里学到了有用的东西,这些知识并不会自动融入模型。”
Hooker认为这是一个随着规模扩大而加剧的结构性问题。部署AI代理的企业在重复付费——计算资源、API调用和基础设施成本——因为模型无法从错误中学习。“你需要能够进化的模型,”她解释道,“否则就会产生巨大的低效。”
效率为何紧迫
这种紧迫感根植于经济因素。据Hooker估计,大约90%的问题都简单到无需动用大型模型。“例如,在批量处理中,许多事情不应该用大型模型来处理。”
她将当前时刻描述为“一个转折点,迫切需要改变模型规模的增长曲线”。企业正在经历的飞涨API费用,正是为每个任务都使用固定、过大的模型带来的直接后果。她认为,未来的AI系统需要能够持续适应新信息并快速调整行为,而不是反复调用一个静态模型。
这种从“为规模而规模”到自适应高效部署的转变,可能深刻重塑AI行业的成本结构。企业将不再花费数十亿美元训练更大的模型,而是投资于能在工作中学习、并随时间推移运行成本越来越低的系统。
硬件竞争白热化
模型开发者通过架构和训练方法追求效率的同时,硬件公司正走另一条路。AI芯片公司SambaNova的CEO Rodrigo Liang表示,当前的挑战是让万亿参数模型运行得足够廉价,以实现真正的部署。
“万亿参数模型仍然过于昂贵和耗电,”Liang说。他公司的策略是通过专为大型模型工作负载设计的芯片,提供更快的推理速度和更低的功耗。他声称,SambaNova的硬件在“相同模型上比[Nvidia] Blackwell [GPU]性能提升2到3倍”,并认为在大规模部署中,这种效率提升是降低成本最直接的途径。
Liang承认,最大的模型短期内不会消失,但他预测“更高效模型有足够的发展空间”。目前,客户仍在与昂贵的扩展、高能耗基础设施以及AI人才短缺作斗争。
对行业的影响
从规模转向效率的宏观变化,对投资者、竞争对手以及整个科技生态系统都意义重大。
对投资者而言: “AI模型越大=回报越高”的叙事正在消退。能够展示成本高效部署和实际投资回报率的公司,很可能获得更高估值。像SambaNova这样在效率指标上挑战Nvidia的硬件初创公司会更具吸引力,但它们面临Nvidia生态锁定带来的巨大挑战。
对竞争对手而言: Nvidia在AI芯片市场的优势基于训练大规模模型时每美元的性能。如果行业转向推理密集型、自适应系统,优势可能转向拥有专用推理芯片的公司。AMD、Intel以及提供专用硅芯片的初创公司可能会获得更多市场份额。
对整个科技行业而言: 企业采用AI一直受困于成本超支。如果模型运行成本更低、更自适应,部署门槛就会降低。这可能加速AI从试验性试点向金融、医疗和企业软件等领域的生产系统转变。
常见问题解答
什么是“巨无霸”AI模型? 巨无霸模型是指一次训练完成后就固定不变的模型。它无法吸收新信息或从用户交互中学习,除非从头再训练,从而导致效率低下。
为什么企业如今更关注效率而非更大的模型? 大规模运行万亿参数模型的成本已变得过高。许多现实任务并不需要最大的模型,而自适应系统可以从错误中学习,避免重复犯错。
SambaNova如何声称能击败Nvidia? SambaNova表示其芯片在相同模型上的每瓦推理性能比Nvidia Blackwell GPU高出2到3倍,从而可能降低运行大型AI工作负载的总成本。
最大的模型会消失吗? 不会。Hooker和Liang都预计,大型模型在尖端研究和复杂任务中仍将保持重要性。但它们将辅以用于常规应用的更小、更高效的模型。
自适应模型何时会普及? Adaption等初创公司正在研究持续学习架构,但Hooker将当前时刻描述为“转折点”。随着基础设施和商业模式的调整,大规模采用可能需要两到四年时间。
这对云AI成本意味着什么? 如果自适应模型减少了冗余API调用和低效计算使用,企业AI账单可能大幅下降。然而,实时模型更新和推理硬件可能带来新的成本。
结论
AI行业正处于转折点。经过多年以计算能力允许的速度扩展模型后,讨论正转向可持续性、成本和适应性——而不仅仅是原始智能。像Hooker和Liang这样的领导者押注,下一波AI价值创造将来自更便宜、随时间更智能、且针对具体问题定制的系统。无论是通过芯片效率还是模型架构来衡量,“越大越好”的时代正在让位于更微妙的理念:可部署、可负担、自适应的AI。