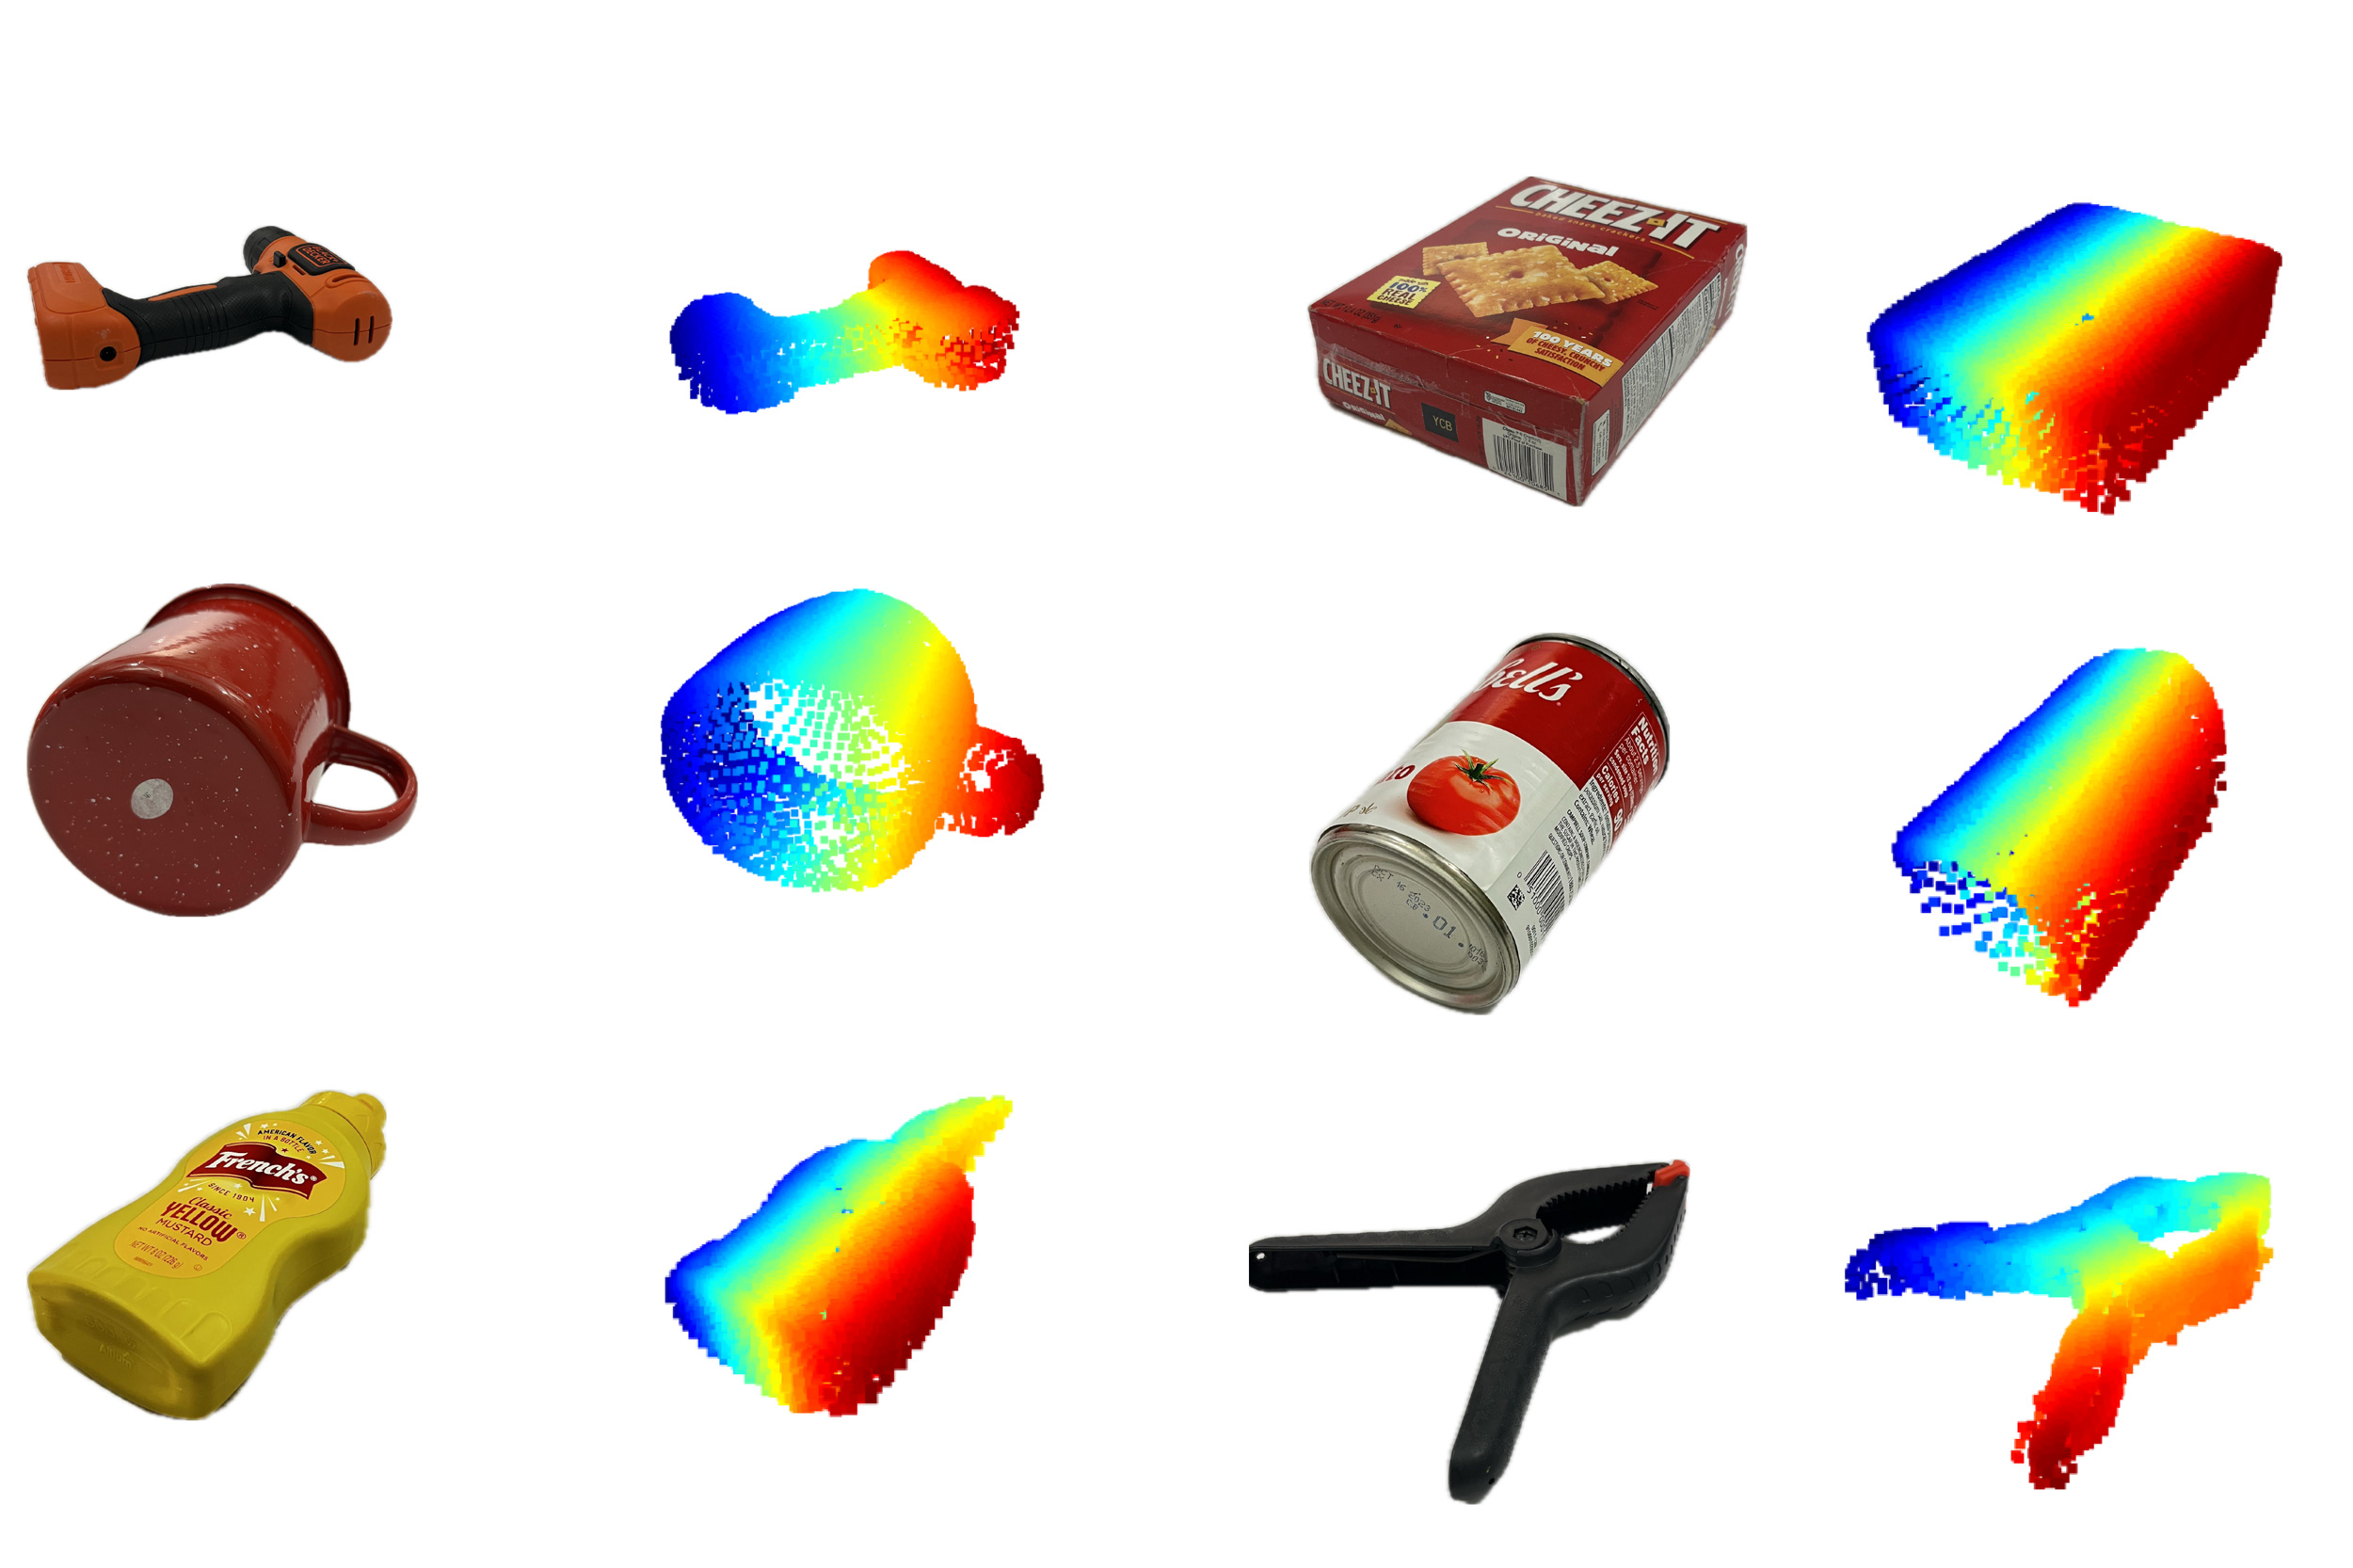
MITの研究者らは、特別に訓練された生成AIモデルを用いて、隠れた3D物体の形状を完成させるシステムを構築した。クレジット:研究者提供。
倉庫やスマートホームで稼働するロボットには根本的な死角がある。カメラの視界から遮られたものは、ロボットにとって存在しないも同然だ。MITの研究者らは、ミリ波無線信号と特殊な生成AIモデルを用いて、カメラを一切使わずに隠れた物体や部屋全体を再構成し、従来手法よりも約20%高い精度を達成した。
- カメラベースのロボットビジョンが抱える構造的欠陥
- Wave-Former:壁越しに隠れた物体を再構成する仕組み
- RISE:単一レーダーから部屋全体をマッピング
- トレーニングデータの問題とMITの解決策
- 倉庫・産業用ロボットへの影響
- よくある質問
カメラベースのロボットビジョンが抱える構造的欠陥
カメラに依存したロボットの認識は、物体が視線の先から外れた瞬間——包装の裏、がれきの下、角の向こう——に機能しなくなる。これは例外的なケースではなく、倉庫や物流センター、家庭環境における日常的な現実だ。ロボットは直接見えない物体の位置を特定し、識別し、つかむ必要がある。
既存の回避策——複数カメラ、構造化光、LiDAR——はすべて同じ制約を持つ:明確な光学的経路が必要だ。段ボール、石膏ボード、プラスチック、さらには厚手の布地が介在すると、ロボットは事実上盲目になる。この制限は、フルフィルメント業務において、誤った梱包アイテムの特定や、生産ラインを停止させるグリップ失敗など、コストのかかるエラーを引き起こす。
MITのSignal Kineticsグループ(准教授Fadel Adib率いる)は、10年以上にわたり、現代のWi-Fiと同じ周波数帯を使用するミリ波レーダー信号を用いた代替手法の構築に取り組んできた。この信号は一般的な障害物を透過し、隠れた物体で反射する。課題は、これまでその反射が不完全で、精密な操作に利用できるほどではなかったことだ。
Wave-Former:壁越しに隠れた物体を再構成する仕組み
MITの新システムWave-Formerは、ミリ波レーダーと生成AIモデルを組み合わせ、障害物の背後に隠れた物体の完全な3D形状を再構成する。約70種類の日常的な物体(缶、箱、器具、果物など)において、従来の最先端手法と比較して約20%の精度向上を達成した。
核心となる物理的問題は鏡面反射性だ。ミリ波信号は鏡のような表面で単一方向に反射する。レーダーセンサーは自分に向かって反射した信号のみを捉えるため、隠れた物体の上面は部分的に見えるが、側面や下面は事実上見えない。従来のシステムは、物理ベースのルールのみを使って不完全な点群を解釈しようとしたが、根本的に限界があった。
Wave-Formerのパイプラインは3段階で動作する。第一に、生のミリ波反射から隠れた物体の部分的な再構成を構築する。第二に、その部分形状を、もっともらしい補完を予測するよう訓練された生成AIモデルに入力する。第三に、表面を反復的に洗練し、完全な3D再構成に収束させる。結果として、ロボットは隠れた物体を検出するだけでなく、その形状を理解し、信頼性の高いグリップを計画できる。
Robohubの研究記事によると、このシステムは段ボール、木材、石膏ボード、プラスチック、布地——実際の倉庫や物流環境に存在する素材——の背後または下に隠された物体に対して検証された。
RISE:単一レーダーから部屋全体をマッピング
MITの2つ目のシステムRISE(Radar-based Indoor Scene Understanding)は、単一の固定ミリ波レーダーからの反射を利用して、家具の配置を含む完全な室内レイアウトを再構成する。既存技術の約2倍の空間精度を達成し、可動式センサープラットフォームを必要としない。
現在の無線シーン再構成のほとんどの手法は、環境をスイープする移動ロボットに搭載されたレーダーを必要とする——これは大きな運用上の制約だ。RISEは別のアプローチをとる:部屋を自然に動き回る人間によって生成されるマルチパス反射を利用する。
人が動くと、ミリ波信号はその人で跳ね返り、さらに壁や家具で反射してレーダーに戻る。通常「ゴースト信号」としてノイズ扱いされるこれらの二次エコーは、実際には部屋のレイアウトに関する空間情報をエンコードしている。人が移動するとゴースト信号が変化し、その位置の変化が周囲の表面の形状を明らかにする。
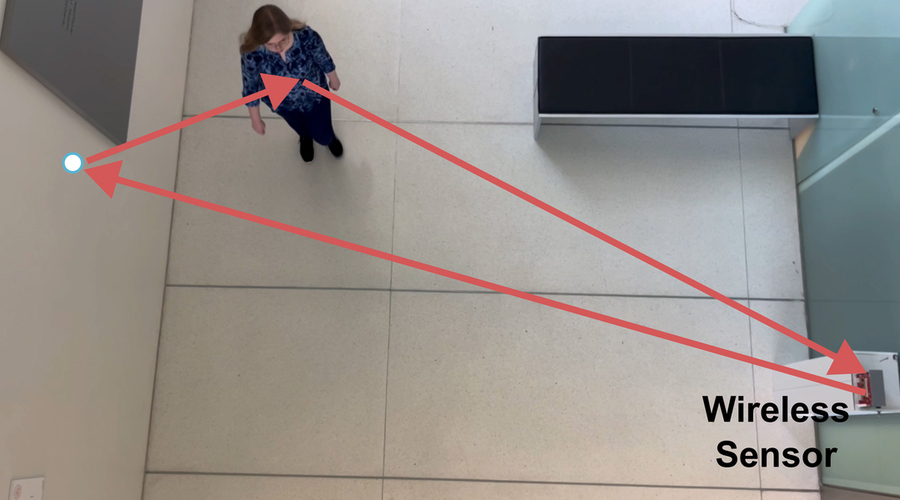 チームはまた、部屋の中を動く人間からの無線信号反射を利用して、屋内シーン全体を完全に再構成する拡張システムを構築した。クレジット:研究者提供。
RISEは、単一の固定レーダーで捉えた100以上の人間の軌跡で検証された。プライバシー面でも注目に値する:カメラシステムと異なり、ミリ波レーダーは個人の視覚画像をキャプチャしないため、カメラが規制や同意の壁に直面する環境でも展開可能だ。
トレーニングデータの問題とMITの解決策
この分野のAIモデルにとって根本的な障害はデータ不足だ:生成モデルをゼロから訓練できるほど大きなミリ波データセットは存在しない。MITの解決策は、既存の大規模コンピュータビジョンデータセット上にミリ波物理をシミュレートすること——つまり、レーダー固有の訓練データを必要とせずにAIにレーダーの言語を教えることだった。
GPTやClaudeのような大規模生成モデルを訓練するには、数百万から数十億のサンプルからなるデータセットが必要だ。ミリ波研究データセットは桁違いに小さい。現実のレーダーデータを十分に収集するには、MITの研究助手Maisy Lam氏が説明するように、「何年もかかっただろう」。
チームの回避策は合成適応だった:既存の大規模コンピュータビジョンデータセットを取り出し、ミリ波反射の物理的特性——鏡面反射性、ノイズ特性、信号形状——を画像データに計算的に付与した。これにより、生成モデルが学習可能な、合成的だが物理的に正確な訓練セットが作成された。
このアプローチは、Physical AI研究で台頭しつつあるより広範なパターン——現実世界のデータが不足または収集コストが高い場合に、物理に基づくシミュレーションでAI訓練をブートストラップする方法——を表している。同じ原理は、シミュレーションから実世界への転送が支配的パラダイムとなっているロボット操作学習の多くを支えている。
| システム | タスク | 信号源 | 精度向上 | センサー構成 |
|---|---|---|---|---|
| Wave-Former | 隠れた物体の3D再構成 | 物体からのミリ波反射 | 最先端比約20% | 可動式または固定レーダー |
| RISE | 完全な室内シーン再構成 | 動く人間からのミリ波反射 | 最先端比約2倍の精度 | 単一固定レーダー |
倉庫・産業用ロボットへの影響
ロボットの購買担当者やエンジニアにとって、これら2つのシステムは異なるが等しく切迫した運用上の問題に対処する:密閉容器内の梱包アイテムの確認、およびロボットが完全なセンサーカバレッジなしで動的環境を理解できるようにすること。
フルフィルメントと梱包確認
現在、倉庫ロボットは密閉された箱の中に何が入っているかを開封せずに確認できない。Wave-Formerが段ボールやプラスチックを通して3D物体形状を再構成する能力は、出荷前の確認という課題に直接取り組む。これはEコマースのフルフィルメントにおいて大きな痛点であり、誤配送による返品率は多大なコストを生む。ミリ波認識を搭載したロボットが、箱を密閉する前にアイテムの存在とおおまかな形状を確認できれば、ラインを遅くすることなく検証が可能になる。
コボットとAMRへのスマート展開
RISEの単一レーダーによる部屋マッピング機能は、人間と空間を共有する自律移動ロボット(AMR)やコボットにすぐに影響を与える。現在の人間追跡アプローチは、高密度のカメラ網(プライバシーの懸念あり)または移動ロボット自体にセンサーを搭載する必要がある。ゴースト信号解析から部屋のライブ空間モデル(人間の位置を含む)を構築する固定レーダーは、動的環境におけるより安全で応答性の高いコボット運用を可能にする。
これらの用途のロボットを評価しているチームは、Wave-Formerのような認識システムの商業統合への進展を追跡しつつ、Robot Overflowで入手可能な中古産業用ロボットやコボットを検討する価値がある。
展開までのタイムライン
両システムとも研究段階にあり、結果はIEEEコンピュータビジョン・パターン認識会議で発表される予定だ。研究はNSF、MITメディアラボ、Amazonが支援しており——後者は商業的な関心を示す重要なシグナルだ。チームの次の目標は、言語におけるGPTやGeminiに相当する無線信号の基盤モデルを構築することで、これにより環境や物体の種類を超えたアプローチの汎用性が飛躍的に向上するだろう。
よくある質問
Wave-Formerとは何か、どのように動作するのか?
Wave-FormerはMITが開発したシステムで、ミリ波レーダー信号を用いて段ボール、石膏ボード、プラスチックなどの障害物の背後に隠れた物体の3D形状を再構成する。レーダー反射から部分的な再構成を構築し、生成AIモデルで欠損形状を補完する。約70種類の日常的な物体でテストし、従来の最先端手法と比較して約20%の精度向上を達成した。
RISEはカメラなしでどのように部屋を再構成するのか?
RISEは単一の固定ミリ波レーダーを使用し、「ゴースト信号」——部屋の中を動く人間で跳ね返り、さらに周囲の家具や壁で反射する二次反射——を利用する。人が動くにつれてこれらのマルチパス反射が変化する様子を追跡することで、生成AIモデルが部屋全体の空間レイアウトを推論する。RISEは100以上のテスト軌跡で、既存の無線シーン再構成技術の約2倍の空間精度を示した。
ミリ波信号はどのような障害物を透過できるのか?
ミリ波信号(Wi-Fiと同じ周波数帯)は、段ボール、木材、石膏ボード、プラスチック、布地など一般的な非金属材料を透過する。金属は効果的に透過できない。このため、商品が段ボールやプラスチックで梱包される倉庫環境に適しているが、金属製の産業用エンクロージャが多くある環境では適用が難しい。
この技術はカメラよりもプライバシーを保護するのか?
はい。ミリ波レーダーは環境内の人の視覚画像を捉えず、信号反射のみを検出する。RISEの部屋マッピング機能は、識別可能な視覚データを記録せずに人間の動きを信号源として使用するため、病院、家庭、規制対象の職場などプライバシーに敏感な環境で、カメラベースの空間マッピングよりも大きな利点がある。
この技術はいつ市販ロボットで利用可能になるのか?
Wave-FormerとRISEはともに研究段階であり、論文はCVPRで発表予定。Amazonが資金パートナーの一社であることから、商業的な関心が示唆されている。MITチームは次に無線信号基盤モデルの構築を優先課題としている。倉庫やコボットシステムへの商業統合は数年先と見られるが、展開可能なハードウェアへの道筋は明確だ。
この研究は、ロボット認識における過去1年で最も実用的な進歩の1つである——わずかなベンチマーク改善ではなく、ロボットが周囲の世界をモデル化する方法における真の構造的変化だ。生成AIはもはや言語や画像のツールではなく、物理システムが直接観測できないものについて推論するための推論エンジンになりつつある。
単一レーダーの部屋認識システムがあれば、施設でのコボットやAMRの導入方法は変わるだろうか?