触覚は人型ロボットを妨げている感覚であり、ケンブリッジ大学の新しいグラフェンベースの触覚センサーは最も信頼性の高い解決策となるかもしれない。Nature Materialsに発表されたこのデバイスは、3次元の力ベクトル、表面テクスチャ、物体の滑りをリアルタイムで、人間の指先に匹敵する空間分解能で検出する。Figure、Apptronik、Tesla Optimusのような人型プラットフォームにとって、このギャップは巧みな操作の静かな制限要因となっている。
なぜ触覚がロボットにとって最も難しい感覚なのか
ほとんどのロボットシステムはミリメートル精度で見え、サブミリメートルの再現性で動くことができる。しかし、生卵を扱う、ラベルをはがす、ケーブルを通すといった、人間の子供でさえ本能的にこなす作業を要求されると、失敗する。その理由は触覚の欠如にある。
人間の指には4つの異なる機械受容体(SA1、SA2、FA1、FA2)があり、それぞれ持続的な圧力、皮膚の伸縮、振動、微細なテクスチャに応答する。これらが連続的で帯域幅の広い多次元データの流れを生成し、脳はミリ秒単位で把持力を調整する。現在のロボットグリッパーにはこれに匹敵するものはない。
研究チームを率いたケンブリッジ大学のTawfique Hasan教授は問題を簡潔に述べている:「既存の触覚センサーのほとんどは、かさばりすぎ、脆すぎ、製造が複雑すぎるか、垂直力と接線力を正確に区別できない。これが真に器用なロボット操作を実現する上での大きな障壁となっている。」
その限界は、今日のあらゆる人型ロボットのデモで見られる。Figure 02、Apptronik Apollo、Tesla Optimusは、注意深く演出された操作タスクでは印象的だが、よく見ると同じ代償戦略が見える。ゆっくりとした過度に慎重な把持、落下を避けるための過剰な締め付け力、予期せぬ滑りに対する反応能力はほぼゼロ。手は有能だが、皮膚はそうではない。
グラフェン触覚センサーの実際の仕組み
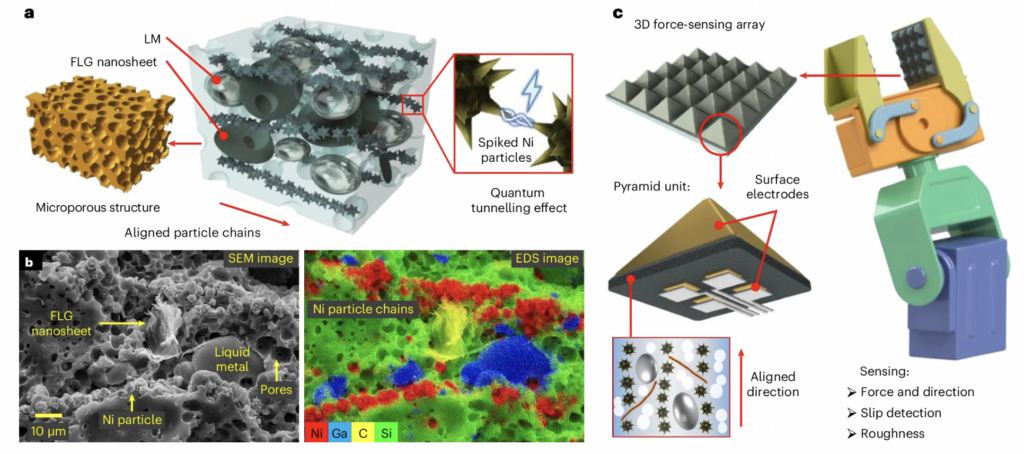
ケンブリッジのセンサーは、材料科学と生体模倣形状の組み合わせでこの問題を解決する。中心材料は軟質複合材料で、グラフェンシート、変形可能な液体金属マイクロ液滴、ニッケル粒子をシリコーンエラストマーマトリックスに懸濁したもの。接触によって材料が変形すると、その電気伝導度が変化し、その変化が力情報を符号化する。
ブレークスルーは形状にある。複合材料は200マイクロメートル(人間の毛髪の直径の約2倍)の小さなピラミッド型微細構造に成形される。この形状は人間の皮膚の微細構造から意図的に借用されており、隆起構造が局所点に機械的応力を集中させる。ピラミッドの先端も同様に人工的に応力集中を増幅し、センサーを極めて低い力に応答させつつ、広い測定範囲を維持する。
各ピラミッドの下には4つの電極が独立した電気信号を取得する。これら4つの読み取り値の相対的な大きさを比較することで、センサーはリアルタイムで完全な3次元力ベクトルを数学的に再構成する—垂直力(真っ直ぐ押す)とせん断力(横滑り)を区別する。このせん断検出により滑り予測が可能になる。センサーはグリップが実際に失敗する前に物体の動きの開始を識別し、事前に修正力を適用できる。
より小さなスケールでは、これらのセンサーのアレイが表面テクスチャ情報を抽出し、物体の事前知識を必要とせずに力信号パターンだけから物体の特性(質量、形状、材料密度)を識別できる。
ベンチマーク性能:比較は?
ケンブリッジチームがNature Materialsに発表したデータは、このセンサーが現在の最先端を大きく超えるものであると位置づけている。主な主張は、新しいデバイスが最小検出力とセンサー面積の両方で既存のフレキシブル触覚センサーを約1桁改善するというもの。
| メトリック | 一般的なフレキシブル触覚センサー | ケンブリッジグラフェンセンサー |
|---|---|---|
| 最小特徴サイズ | ~2,000–5,000 µm | ~200 µm |
| 力検出能力 | ミリニュートン範囲 | 砂粒1つを検出 |
| 力の次元 | 垂直力のみ(ほとんどの場合) | 完全な3次元ベクトル(垂直+せん断) |
| 滑り検出 | 滑り後(反応的) | 滑り前(予測的) |
| 製造の複雑さ | 高い(光学または剛性構造) | 軟質複合材料、光学不要 |
| スケーラビリティ目標 | 限定的 | 将来的に50 µm以下 |
センサーはロボットグリッパーのデモで検証され、ロボットが薄い紙管(過剰な力で潰れる物体)を損傷なく把持できるようになった。この種のタスクには、リアルタイムで校正されるサブニュートン力制御が必要である。従来のセンサーはプログラム済みの物体特性仮定に依存しており、このような適応ができない。
人型ロボットとコボットへの影響
このセンサー単独では人型ロボットの巧みさを解決しないが、スタックの中で最も頑固なハードウェアのボトルネックに対処する。現在多くの人型プラットフォームで使われている視覚ベースの操作は、基本的な物理的限界がある。カメラの遅延、接触時の遮蔽、内部把持力の感知不能性により、最高の視覚言語行動モデルでも指先が物体に触れた瞬間から部分的に盲目になる。
予測的滑り検出と3次元力分解能を備えた触覚スキンは、フィードバックループを完全に変える。落下が発生した後に反応する代わりに、ロボットは差し迫った滑りを示すベクトルシフトを感知し、同じ制御サイクルで修正トルクを適用できる。衣類をたたむ、ガラス製品を扱う、小さな部品を組み立てる、医療現場で患者を支援するといったタスクでは、その差が展開可能かどうかの境界線となる。
小型化のロードマップも重要である。チームは50マイクロメートル以下のセンサー特徴への道筋を報告しており(実際のヒト皮膚の機械受容体密度に近づく)、将来のバージョンでは温度・湿度センシングを統合する可能性がある。この軌道は、単なる孤立した指先センサーではなく、人型ロボットの手のための完全な人工皮膚への信頼できる道筋にこの研究を位置づけている。
協働ロボット(コボット)アプリケーションにとっても、その意味は同様に重要である。力感応操作はUniversal Robots URシリーズやFANUC CRXラインのようなプラットフォームですでに売り物になっているが、現在の実装は手首全体の力を検出するものであり、接触面の局所的な触覚イベントではない。このようなセンサーは、コボットグリッパーレベルで指ごと、接触点ごとのデータを可能にする。組立や検査タスク用の中古コボットを評価している場合、これが注視すべき能力の方向性である。
ロボット購入者と開発者への意味
人型ロボットの開発者や購入者にとって、この研究は触覚センシングが学術的な好奇心から近い将来のハードウェアコンポーネントへと移行していることを示している。Cambridge Enterpriseを通じて特許が出願されており、商業化は推測的な結果ではなく積極的な目標である。ライセンスや商業化のタイムラインは未公開だが、ARIA(英国先端研究発明庁)の関与は生産規模の開発が視野に入っていることを示唆している。
コボットや産業用グリッパーインテグレーターにとって、3次元力ベクトル+滑り検出の組み合わせは、精密組立、医療機器取り扱い、食品加工など、把持制御に現在カスタム治具や低速・保守的な動作プロファイルが必要なアプリケーションに直ちに関連する。
義肢開発者にとって、論文は高度な人工肢への触覚フィードバックを直接の応用経路として明示している。ロボットハンドに利益をもたらす同じ小型化された皮膚様センシングは、義手ユーザーに意味のある触覚フィードバックを回復させる可能性があり、この技術の重要な二次市場となる。
この研究は王立協会、ヘンリー・ロイス研究所、ARIAの支援を受けた。論文「Multiscale-structured miniaturized 3D force sensors」はNature Materials (2026)に掲載されている。Robot Overflowで人型ロボットを評価しているチームは、今すぐ触覚センシング能力をハードウェア評価基準に加える価値がある。
よくある質問
ケンブリッジのグラフェン触覚センサーとは何ですか?何を検出しますか?
このセンサーは、グラフェン、液体金属マイクロ液滴、ニッケル粒子からなる軟質フレキシブル複合材料で、シリコーン基板上に200マイクロメートルのピラミッド型微細構造に成形されている。垂直力、せん断力、3次元力ベクトル、表面テクスチャ、物体の滑りを同時に検出し、人間の指先の多次元センシングに密接に匹敵する。
このセンサーは既存のロボット触覚センサーとどう比較されますか?
Nature Materialsの論文によれば、ケンブリッジのセンサーは最小検出力と空間分解能の両方で現在のフレキシブル触覚センサーを約1桁改善している。また、予測的滑り検出と3次元力ベクトル再構成を追加しており、ほとんどの市販センサーが完全に欠いているか、不十分にしか近似できない機能である。
このグラフェン触覚センサーはいつ市販ロボットで利用可能になりますか?
商業リリース日は未発表。ケンブリッジ大学の事業化部門であるCambridge Enterpriseを通じて特許出願が行われており、ライセンスまたはスピンアウトを積極的に追求していることを示している。ARIAの支援を受けており、技術は生産規模の開発を目指しているように見えるが、学術特許出願から商業展開までの典型的なタイムラインはセンサーハードウェアで3~7年である。
なぜ滑り検出が人型ロボットの巧みさにとって重要なのですか?
滑り検出、特に予測的滑り検出(グリップが失敗する前に動きの開始を識別する)により、ロボットは物体がすでに落下した後に反応するのではなく、リアルタイムで修正力を適用できる。これがないと、ロボットは安全バッファとして過剰な把持力を使わなければならず、壊れやすい物体や変形しやすい物体の取り扱いが不可能になる。これは、非構造化操作タスクに取り組む人型プラットフォームの直接的なボトルネックである。
このセンサーは義手に使用できますか?
はい。ケンブリッジの研究者は高度な義肢をアプリケーション経路として明示的に挙げている。ロボットグリッパーに利益をもたらす同じ小型化された3次元力センシングは、義肢ユーザーに触覚フィードバックを回復させ、把持制御、安全性認識、物体操作時のユーザーの自信を向上させる可能性がある。
この技術の次の開発ステップは何ですか?
チームの公表ロードマップには、センサーを50マイクロメートル以下に小型化し(人間の皮膚の機械受容体密度に近づく)、将来のバージョンに温度・湿度センシングを統合して、力のみのデバイスではなく完全なマルチモーダル人工皮膚へと進化させることが含まれている。
ケンブリッジのグラフェン触覚センサーは、人型ロボットと協働ロボットにおける触覚センシングのギャップを埋めるための、これまでに発表された中で最も技術的に信頼性の高い一歩である。次世代の人型ロボットの手に出荷されることはないだろうが、この論文から製造部品への道筋はかつてないほど明確になっている。
今日人型ロボットを構築または購入している場合、触覚の欠如は実際にあなたの操作パイプラインにどれだけのコストをもたらしているだろうか?