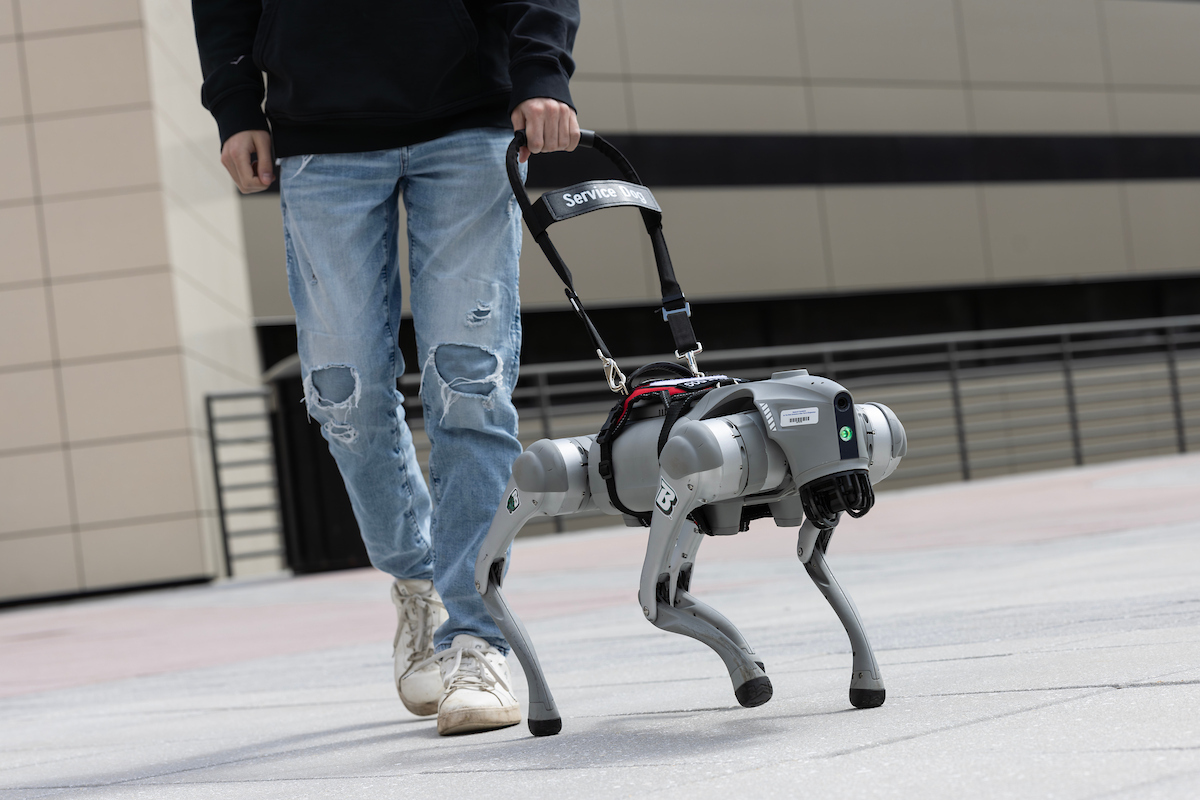
ビンガムトン大学の研究チームは、四足歩行ロボットにGPT-4を搭載し、視覚障がい者と音声でコミュニケーションできるロボット盲導犬を開発しました。出発前に経路を説明し、移動中は周囲の状況をリアルタイムで音声案内します。7人の全盲の被験者による実証実験では、通常20程度のコマンドしか理解できない生体の盲導犬と比較して、測定可能な能力の飛躍が示されました。
目次
ビンガムトン大学が実際に開発したもの
このシステムは、四足歩行ロボットにGPT-4の音声統合機能を組み合わせたもので、移動前の「経路説明」と移動中の「状況説明」という2つの音声モードを備えています。移動前に利用可能な経路と推定移動時間を説明し、歩行中は廊下や障害物、空間の状況などを自然言語で実況します。
これはアーキテクチャ上の重要な転換です。同大学のシーチー・ジャン准教授(トーマス・J・ワトソン校コンピューティング学部)が率いるこれまでの研究では、ロボットはリードの引っ張りに反応するだけでしたが、LLMを重ねることで、反応型のナビゲーションツールが会話型のナビゲーションパートナーへと変貌しました。
論文「"From Woofs to Words: Towards Intelligent Robotic Guide Dogs with Verbal Communication"」は、第40回AAAI人工知能学会年次大会で発表されました。この学会は同分野で最も影響力のある会合の一つであり、厳格な査読を経た研究であることが示されています。
The Robot Reportによると、グラスゴー大学でも同様のシステムが研究されており、支援技術系スタートアップのGlidanceは車輪型のバリエーションを開発していますが、出発前の経路計画とリアルタイムの音声案内を組み合わせたシステムは今回が初めてです。
本物の盲導犬との比較
純粋な言語能力の面では、ロボットシステムはケタ違いです。生体の盲導犬は最大でも約20のコマンドしか理解しませんが、GPT-4を統合することで、複雑な多段階指示やフォローアップ質問、文脈に応じた会話を無制限に処理できます。
| 能力 | 生体の盲導犬 | GPT-4搭載ロボット盲導犬 |
|---|---|---|
| コマンド語彙 | 約20コマンド | 事実上無制限(自然言語) |
| 経路計画の音声説明 | なし | あり(移動前の説明) |
| リアルタイム状況説明 | なし | あり(継続的な実況) |
| 障害物回避 | あり(訓練済み) | あり(センサーに基づく) |
| 感情サポート | 高い | 限定的 |
| 訓練期間 | 18~24か月 | ソフトウェア展開で完了 |
| 入手可能性 | 利用対象者の約2% | 原則としてスケーラブル |
生体の盲導犬の利点は軽視できません。長年の訓練による状況判断力、段差を越える体力、そしてハンドラーとの情緒的な絆は、クラウドAPI上で推論を実行する四足ロボットでは再現できません。特に予測不可能な屋外環境では、センサーのエッジケースが急増するため、類似性は限定されます。
ロボットシステムが提供するのは補完的な能力、つまり生体の盲導犬には不可能な音声による状況認識と、スケーラビリティです。業界データによると、世界の2億5300万人の視覚障がい者のうち、盲導犬を利用できるのは約2%にすぎません。ロボットシステムは1台ごとに2年もの専門訓練を必要としません。
実験の結果
7人の全盲被験者が、広い多目的オフィス環境でロボットを使って移動しました。タスクは指定された会議室に到着することです。ロボットはまず音声で行き先を尋ね、経路オプションと所要時間を提示した後、環境を実況しながら誘導しました。廊下の長さ、空間の変化、途中の障害物などを音声で伝えました。
移動後のアンケートでは、有用性、コミュニケーションのしやすさ、全体的な評価が測定されました。被験者は一貫して「複合モード」(移動前の経路説明とリアルタイムの状況説明の両方)を、どちらか一方のみの場合よりも高く評価しました。並行して行われたシミュレーション研究でも、この結果が定量的に裏付けられました。
ジャン氏は被験者の反応を「非常に熱心で、ロボットの可能性を実感し、実用化を強く望んでいた」と述べています。
ただし、7人という被験者数と管理された屋内オフィス環境は概念実証の規模であり、実用化を検証したものではありません。研究チームもこの点を認めており、今後は被験者を増やし、自律性を高め、屋内・屋外の長距離ナビゲーション試験を計画しています。実際の雨天や群衆、不整地での性能は未検証です。
ロボット工学と支援技術への影響
ビンガムトン大学の研究は支援技術を超えた意義を持っています。四足歩行ロボットに汎用言語モデルを主要なユーザーインターフェースとして搭載した初期のデモンストレーションであり、そのアーキテクチャパターンは幅広い応用が可能です。
四足歩行ロボットプラットフォームの開発者にとって、コモディティ化したLLM APIがカスタムモデル訓練なしに既存ハードウェアの有用性を大幅に拡大できることを示しています。Unitree Go2などのプラットフォームにこのソフトウェアスタックを搭載すれば、基本ハードウェアからは想像もつかない製品に変貌します。中古のコボットやモバイルロボットプラットフォームを検討しているバイヤーは、ハードウェアの交換ではなくソフトウェアのアップグレードが能力階層を定義する時代になりつつあることを認識すべきです。
支援ロボット市場では、供給不足が真の課題です。世界中の盲導犬訓練機関が毎年生産する頭数は数千に過ぎず、需要を満たせません。大量生産可能でソフトウェア更新できるロボットシステムは、屋外ナビゲーションと耐久性の課題が解決されれば、構造的な解決策となります。
より広範なPhysical AIの流れにおいて、四足歩行+マルチモーダルLLM+実世界タスク実行というパターンは、ヒューマノイドロボット、点検プラットフォーム、物流システムに同時に現れています。ビンガムトンの研究は、より大きな収束の中での特定分野の実証点です。ヒューマノイドロボット市場を追跡している方は、言語能力を持つ身体化システムが、予想をはるかに上回る速度で研究室から構造化された実世界環境に移行していることに気づくでしょう。
このプロジェクトの次なる課題は屋外での自律性です。縁石、交差点、変化する地形、歩行者への対応は、概念実証と実用可能な製品の間にある大きなギャップです。
よくある質問
ビンガムトン大学のチームは盲導犬システムにどのロボットハードウェアを使用しましたか?
論文では具体的な市販の四足歩行ロボットプラットフォームを明記していませんが、システムは四足歩行ロボットにGPT-4を統合したもので、音声処理と自然言語生成を行います。研究はソフトウェアアーキテクチャに焦点を当てており、UnitreeやBoston Dynamicsのハードウェアなど、市販の四足歩行ロボットに展開可能な設計です。
GPT-4の統合は特にどのように盲導犬のナビゲーションを向上させますか?
GPT-4により、生体の盲導犬では不可能な2つの機能が実現します。移動前に複数の経路と所要時間を自然言語で説明できること、および移動中に環境を継続的に音声説明できることです。生体の盲導犬は約20のコマンドしか理解しませんが、GPT-4統合によりユーザーはフォローアップ質問、経路変更の依頼、詳細な環境説明の要求をリアルタイムで行えます。
世界的にロボット盲導犬の恩恵を受けられる人はどれくらいいますか?
世界では約2億5300万人が視覚障がいを抱えています。現在の盲導犬の普及率は、対象者の約2%にすぎません。1頭あたり18~24か月の訓練期間と、専門訓練プログラムの数が限られているためです。大量生産とソフトウェア更新が可能なロボットシステムは、このアクセス格差の構造的解決策となります。
ビンガムトンのロボット盲導犬は実用化されていますか?
いいえ。現システムは管理された屋内オフィス環境で7人の被験者による検証が行われた段階です。研究チームは長距離、自律性向上、屋外ナビゲーションを含むさらなる研究を計画しています。不整地、群衆、悪天候での性能は未検証であり、概念実証と実用製品の間の主要なギャップとなっています。
この技術は盲導犬ロボット以外のプラットフォームにも応用できますか?
はい。四足歩行とLLM駆動の音声対話、リアルタイム状況説明を組み合わせたコアアーキテクチャは、点検ロボット、倉庫ナビゲーションアシスタント、汎用サービスロボットに直接応用可能です。現在固定コマンドセットや手動遠隔操作に依存するあらゆる四足歩行・移動プラットフォームが、同じ統合アプローチで自然言語インターフェースを獲得できます。
ビンガムトン大学のロボット盲導犬は、Physical AI(LLMを通じて推論する身体化ロボット)が、ハードウェアだけでは解決できない現実のアクセス問題を解決できることを示す最も明確なデモンストレーションです。研究室での概念実証とスケーラブルな展開の間には大きなギャップがありますが、そのアーキテクチャの設計図は査読を経て公開されました。
GPT-4搭載ロボット犬に混雑した街の交差点をナビゲートさせたいと思いますか? そのためには何が必要でしょうか?