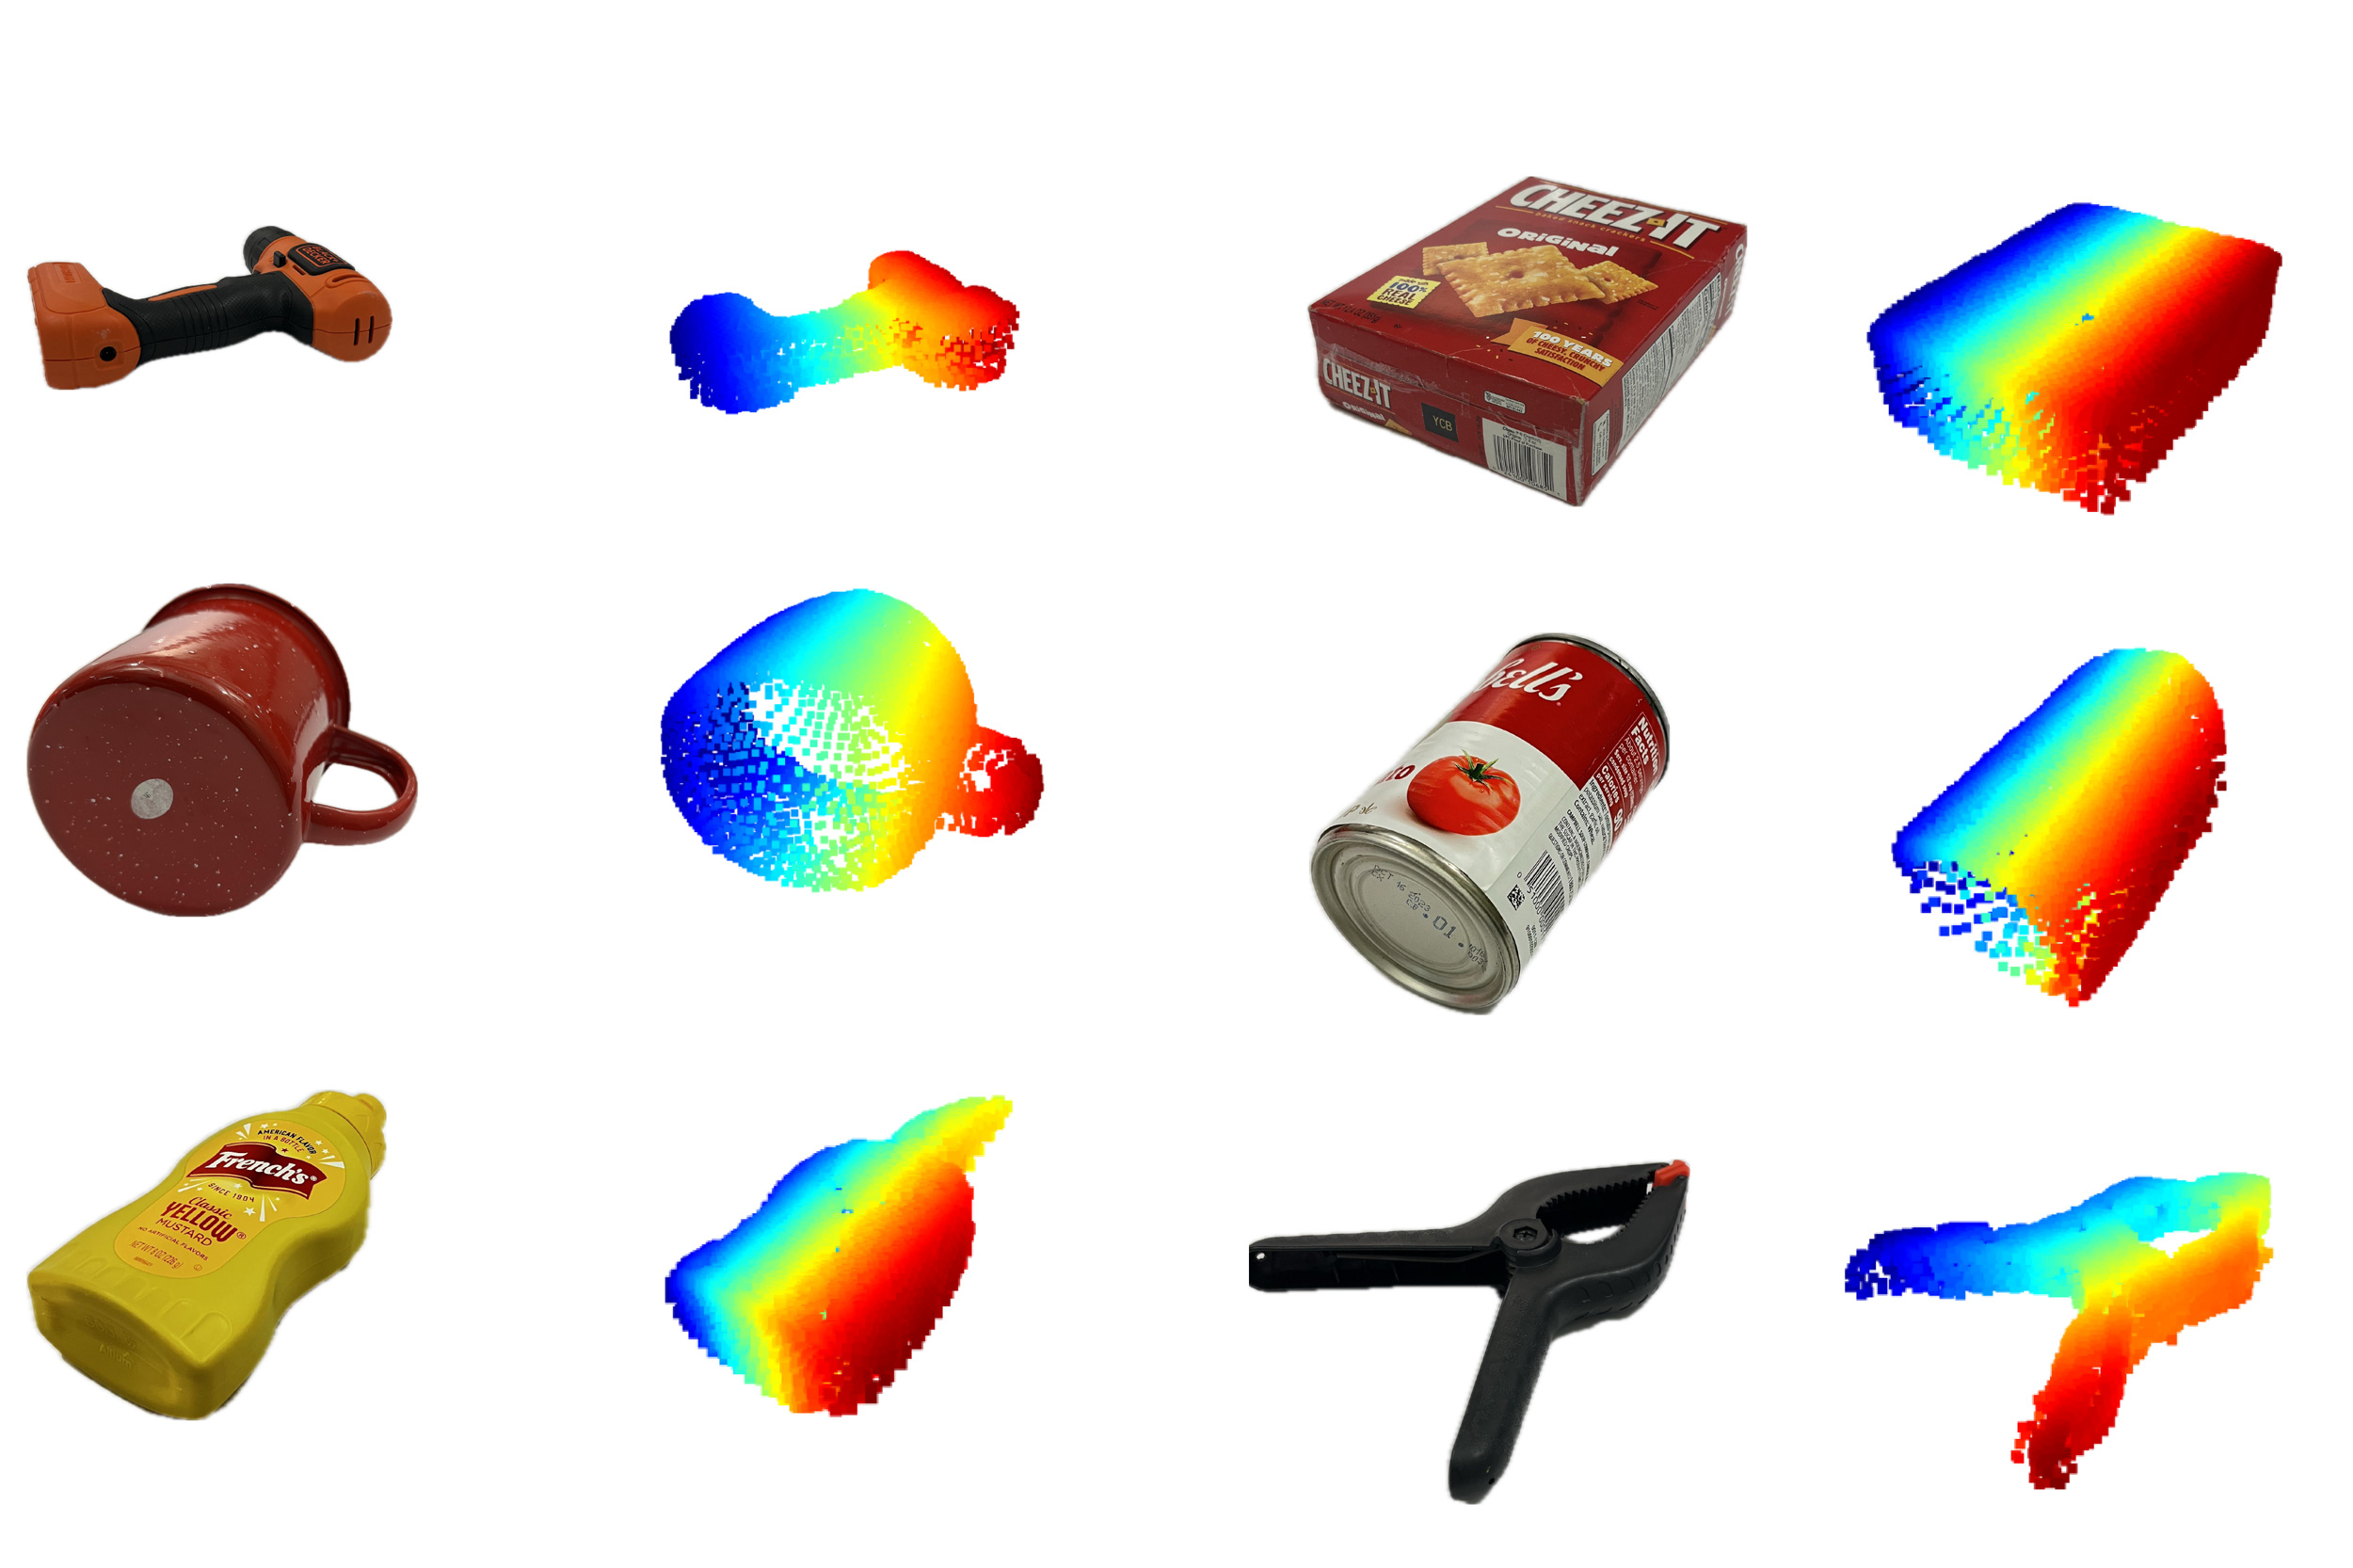
นักวิจัย MIT ใช้โมเดล generative AI ที่ถูกฝึกมาโดยเฉพาะเพื่อสร้างระบบที่สามารถเติมเต็มรูปร่างของวัตถุ 3 มิติที่ซ่อนอยู่ เครดิต: ได้รับความอนุเคราะห์จากนักวิจัย
หุ่นยนต์ที่ทำงานในคลังสินค้าและบ้านอัจฉริยะมีจุดบอดพื้นฐาน: สิ่งใดก็ตามที่ถูกบังจากกล้องของพวกมัน จะไม่มีอยู่จริงสำหรับพวกมัน ตอนนี้นักวิจัย MIT ได้นำ generative AI มาใช้แก้ไขปัญหานี้ โดยใช้สัญญาณไร้สายแบบมิลลิเมตรเวฟและโมเดล AI ที่ถูกฝึกมาเป็นพิเศษ เพื่อสร้างวัตถุที่ซ่อนอยู่และทั้งห้องขึ้นมาใหม่ด้วยความแม่นยำที่สูงขึ้น เกือบ 20% เมื่อเทียบกับวิธีการก่อนหน้านี้ โดยไม่ต้องใช้กล้องแม้แต่ตัวเดียว
- ทำไมการมองเห็นของหุ่นยนต์ที่ใช้กล้องถึงมีจุดอ่อนเชิงโครงสร้าง
- Wave-Former สร้างวัตถุที่ซ่อนอยู่ทะลุกำแพงได้อย่างไร
- RISE: การทำแผนที่ทั้งห้องจากเรดาร์ตัวเดียว
- ปัญหาข้อมูลฝึกสอน — และวิธีที่ MIT แก้ไข
- สิ่งนี้หมายถึงอะไรสำหรับหุ่นยนต์คลังสินค้าและอุตสาหกรรม
- คำถามที่พบบ่อย
ทำไมการมองเห็นของหุ่นยนต์ที่ใช้กล้องถึงมีจุดอ่อนเชิงโครงสร้าง
การรับรู้ของหุ่นยนต์ที่พึ่งพากล้องจะล้มเหลวทันทีที่วัตถุเคลื่อนออกจากแนวสายตา — หลังบรรจุภัณฑ์ ใต้เศษซาก หรือรอบมุม นี่ไม่ใช่กรณีขอบ; มันคือความจริงในการปฏิบัติงานประจำวันในคลังสินค้า ศูนย์กระจายสินค้า และสภาพแวดล้อมภายในบ้าน ที่หุ่นยนต์จำเป็นต้องค้นหา ระบุ และหยิบจับวัตถุที่พวกมันมองไม่เห็นโดยตรง
วิธีแก้ปัญหาที่มีอยู่ — กล้องหลายตัว แสงโครงสร้าง LiDAR — ล้วนมีข้อจำกัดเดียวกัน: พวกมันต้องการเส้นทางแสงที่ชัดเจน ทันทีที่กระดาษแข็ง ยิปซัม พลาสติก หรือแม้แต่ผ้าทึบเข้ามาเกี่ยวข้อง หุ่นยนต์ก็จะตาบอดโดยสิ้นเชิง ข้อจำกัดนี้ก่อให้เกิดข้อผิดพลาดที่มีต้นทุนสูงในการดำเนินการจัดส่ง รวมถึงการระบุสินค้าที่บรรจุผิดพลาดและการหยิบจับที่ล้มเหลวซึ่งทำให้สายการผลิตหยุดชะงัก
กลุ่ม Signal Kinetics ของ MIT นำโดยรองศาสตราจารย์ Fadel Adib ใช้เวลากว่าทศวรรษในการสร้างทางเลือกอื่นโดยใช้ สัญญาณเรดาร์แบบมิลลิเมตรเวฟ (mmWave) — ย่านความถี่เดียวกับที่ใช้ใน Wi-Fi สมัยใหม่ — ซึ่งสามารถทะลุผ่านสิ่งกีดขวางทั่วไปและสะท้อนจากวัตถุที่ซ่อนอยู่ ความท้าทายจนถึงขณะนี้คือ การสะท้อนเหล่านั้นไม่สมบูรณ์พอที่จะมีประโยชน์สำหรับการจัดการที่แม่นยำ
Wave-Former สร้างวัตถุที่ซ่อนอยู่ทะลุกำแพงได้อย่างไร
Wave-Former ระบบใหม่ของ MIT ผสมผสานเรดาร์ mmWave เข้ากับโมเดล generative AI เพื่อสร้างรูปร่าง 3 มิติที่สมบูรณ์ของวัตถุที่ซ่อนอยู่หลังสิ่งกีดขวาง — โดยมีความแม่นยำเพิ่มขึ้นเกือบ 20% เมื่อเทียบกับวิธีการล้ำสมัยก่อนหน้านี้จากวัตถุในชีวิตประจำวันประมาณ 70 ชิ้น包括กระป๋อง กล่อง อุปกรณ์เครื่องใช้ และผลไม้
ปัญหาทางฟิสิกส์หลักคือ specularity: สัญญาณ mmWave สะท้อนจากพื้นผิวในทิศทางเดียว เช่นแสงจากกระจก เซ็นเซอร์เรดาร์จะจับเฉพาะการสะท้อนที่กลับมายังมันเท่านั้น หมายความว่าพื้นผิวด้านบนของวัตถุที่ซ่อนอยู่จะมองเห็นได้บางส่วน ในขณะที่ด้านข้างและด้านล่างจะมองไม่เห็นโดยสิ้นเชิง ระบบก่อนหน้านี้พยายามตีความกลุ่มจุดที่ไม่สมบูรณ์เหล่านี้โดยใช้กฎทางฟิสิกส์เพียงอย่างเดียว — ซึ่งเป็นแนวทางที่มีข้อจำกัดโดยพื้นฐาน
ไปป์ไลน์ของ Wave-Former ทำงานในสามขั้นตอน ขั้นแรก มันสร้างการสร้างใหม่บางส่วนของวัตถุที่ซ่อนอยู่จากการสะท้อน mmWave ดิบ ขั้นที่สอง มันป้อนรูปร่างบางส่วนนั้นให้กับโมเดล generative AI ที่ถูกฝึกให้ทำนายการเติมเต็มที่เป็นไปได้ ขั้นที่สาม มันปรับแต่งพื้นผิวอย่างต่อเนื่องจนกว่าจะได้การสร้างใหม่ 3 มิติที่สมบูรณ์ ผลลัพธ์: หุ่นยนต์ไม่เพียงแต่สามารถตรวจจับวัตถุที่ซ่อนอยู่ แต่ยังเข้าใจเรขาคณิตของมันเพียงพอที่จะวางแผนการหยิบจับที่เชื่อถือได้
ตาม รายงานของ Robohub เกี่ยวกับงานวิจัยนี้ ระบบถูกตรวจสอบความถูกต้องกับวัตถุที่ซ่อนอยู่หลังหรือใต้กระดาษแข็ง ไม้ ยิปซัม พลาสติก และผ้า — ซึ่งเป็นวัสดุที่พบได้จริงในสภาพแวดล้อมคลังสินค้าและโลจิสติกส์
RISE: การทำแผนที่ทั้งห้องจากเรดาร์ตัวเดียว
ระบบที่สองของ MIT, RISE (Radar-based Indoor Scene Understanding), สร้างผังห้องทั้งหมดขึ้นใหม่ — รวมถึงตำแหน่งเฟอร์นิเจอร์ — โดยใช้การสะท้อนจากเรดาร์ mmWave ตัวเดียวที่อยู่กับที่ โดยมีความแม่นยำเชิงพื้นที่ประมาณสองเท่าของเทคนิคที่มีอยู่ และไม่ต้องใช้เซ็นเซอร์เคลื่อนที่
วิธีการสร้างฉากไร้สายในปัจจุบันส่วนใหญ่ต้องติดตั้งเรดาร์บนหุ่นยนต์ที่เคลื่อนที่เพื่อสแกนสภาพแวดล้อม — ซึ่งเป็นข้อจำกัดในการปฏิบัติงานที่สำคัญ RISE ใช้แนวทางที่แตกต่าง: มันใช้ประโยชน์จาก การสะท้อนแบบหลายเส้นทาง (multipath reflections) ที่เกิดจากการเคลื่อนที่ของมนุษย์ในห้องอย่างเป็นธรรมชาติ
เมื่อคนเคลื่อนที่ สัญญาณ mmWave จะสะท้อนจากพวกเขา จากนั้นสะท้อนอีกครั้งจากผนังและเฟอร์นิเจอร์ก่อนกลับมายังเรดาร์ เสียงสะท้อนรองเหล่านี้ — ซึ่งโดยทั่วไปถูกทิ้งเป็นสัญญาณรบกวนภายใต้ป้ายกำกับ "สัญญาณผี (ghost signals)" — จริงๆ แล้วเข้ารหัสข้อมูลเชิงพื้นที่เกี่ยวกับผังของห้อง เมื่อคนเคลื่อนที่ สัญญาณผีจะเปลี่ยนตำแหน่ง และตำแหน่งที่เปลี่ยนไปจะเปิดเผยเรขาคณิตของพื้นผิวโดยรอบ
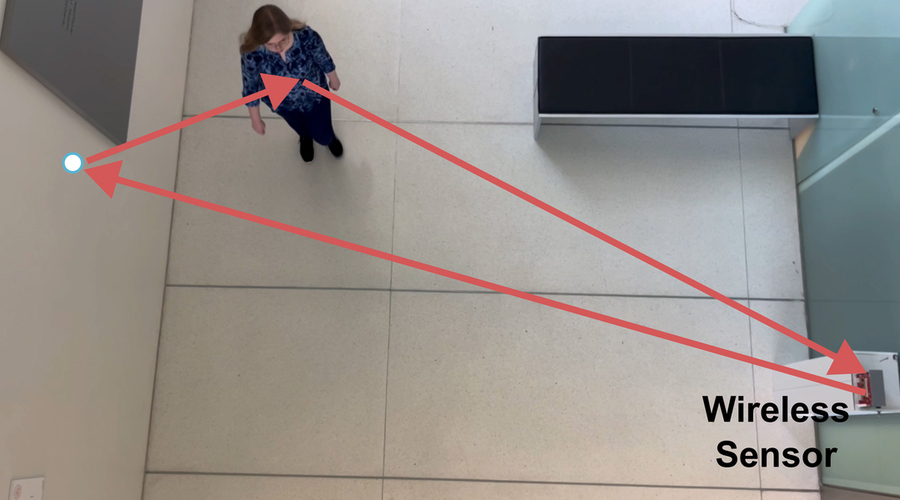 ทีมงานยังสร้างระบบที่ขยายใหญ่ขึ้นซึ่งสร้างฉากในร่มทั้งหมดขึ้นใหม่โดยใช้การสะท้อนสัญญาณไร้สายจากมนุษย์ที่เคลื่อนที่ในห้อง เครดิต: ได้รับความอนุเคราะห์จากนักวิจัย
RISE ถูกตรวจสอบความถูกต้องด้วย วิถีมนุษย์มากกว่า 100 เส้นทาง ที่บันทึกโดยเรดาร์ที่อยู่กับที่เพียงตัวเดียว นัยสำคัญด้านความเป็นส่วนตัวก็น่าสังเกต: ต่างจากระบบกล้อง เรดาร์ mmWave ไม่บันทึกภาพที่มองเห็นของบุคคล ทำให้สามารถนำไปใช้ในสภาพแวดล้อมที่กล้องเผชิญอุปสรรคด้านกฎระเบียบหรือข้อตกลงยินยอม
ปัญหาข้อมูลฝึกสอน — และวิธีที่ MIT แก้ไข
อุปสรรคพื้นฐานสำหรับโมเดล AI ใดๆ ในพื้นที่นี้คือความขาดแคลนข้อมูล: ไม่มีชุดข้อมูล mmWave ที่ใหญ่พอที่จะฝึกโมเดล generative ตั้งแต่เริ่มต้น วิธีแก้ของ MIT คือการจำลองฟิสิกส์ mmWave บนชุดข้อมูลคอมพิวเตอร์วิทัศน์ขนาดใหญ่ที่มีอยู่ — โดยพื้นฐานแล้วเป็นการสอน AI ภาษาเรดาร์โดยไม่ต้องใช้ข้อมูลฝึกสอนเฉพาะเรดาร์
การฝึกโมเดล generative ขนาดใหญ่เช่น GPT หรือ Claude ต้องใช้ชุดข้อมูลที่มีตัวอย่างเป็นล้านหรือพันล้าน ชุดข้อมูลการวิจัย mmWave มีขนาดเล็กกว่าหลายเท่า การรวบรวมข้อมูลเรดาร์ในโลกจริงให้เพียงพอจะใช้เวลา "หลายปี" ตามที่ Maisy Lam ผู้ช่วยวิจัยของ MIT กล่าว
วิธีแก้ของทีมคือการปรับสังเคราะห์: พวกเขานำชุดข้อมูลคอมพิวเตอร์วิทัศน์ขนาดใหญ่ที่มีอยู่ และบังคับใช้คุณสมบัติทางกายภาพของการสะท้อน mmWave — ความเป็น specularity ลักษณะสัญญาณรบกวน เรขาคณิตของสัญญาณ — กับข้อมูลภาพโดยใช้การคำนวณ สิ่งนี้สร้างชุดข้อมูลฝึกสอนสังเคราะห์ที่แม่นยำทางฟิสิกส์ซึ่งโมเดล generative สามารถเรียนรู้ได้
แนวทางนี้เป็นตัวแทนของรูปแบบที่เกิดขึ้นใหม่ในการวิจัย Physical AI: การใช้ การจำลองที่คำนึงถึงฟิสิกส์ (physics-informed simulation) เพื่อสนับสนุนการฝึก AI ในที่ที่ข้อมูลโลกจริงขาดแคลนหรือมีค่าใช้จ่ายสูงในการรวบรวม หลักการเดียวกันนี้รองรับความก้าวหน้าส่วนใหญ่ในการเรียนรู้การจัดการของหุ่นยนต์ ซึ่งการถ่ายโอนจากซิมสู่จริง (sim-to-real transfer) ได้กลายเป็นกระบวนทัศน์ที่โดดเด่น
| ระบบ | งาน | แหล่งสัญญาณ | ความแม่นยำที่เพิ่มขึ้น | การกำหนดค่าเซ็นเซอร์ |
|---|---|---|---|---|
| Wave-Former | การสร้างใหม่ 3 มิติของวัตถุที่ซ่อนอยู่ | การสะท้อน mmWave จากวัตถุ | ~20% เหนือ SOTA | เรดาร์เคลื่อนที่หรืออยู่กับที่ |
| RISE | การสร้างฉากห้องทั้งห้อง | การสะท้อน mmWave จากมนุษย์ที่เคลื่อนที่ | ~2 เท่าของความแม่นยำเหนือ SOTA | เรดาร์ที่อยู่กับที่ตัวเดียว |
สิ่งนี้หมายถึงอะไรสำหรับหุ่นยนต์คลังสินค้าและอุตสาหกรรม
สำหรับผู้ซื้อและวิศวกรหุ่นยนต์ ระบบทั้งสองนี้แก้ปัญหาการปฏิบัติงานที่แตกต่างแต่เร่งด่วนเท่าเทียมกัน: การตรวจสอบสินค้าที่บรรจุในภาชนะปิดสนิท และการทำให้หุ่นยนต์เข้าใจสภาพแวดล้อมที่เปลี่ยนแปลงโดยไม่ต้องครอบคลุมเซ็นเซอร์เต็มรูปแบบ
การจัดส่งและการตรวจสอบบรรจุภัณฑ์
ปัจจุบันหุ่นยนต์ในคลังสินค้าไม่สามารถยืนยันสิ่งที่อยู่ในกล่องปิดสนิทได้โดยไม่ต้องเปิดมัน ความสามารถของ Wave-Former ในการสร้างเรขาคณิต 3 มิติของวัตถุผ่านกระดาษแข็งและพลาสติกช่วยแก้ปัญหาการตรวจสอบก่อนจัดส่งได้โดยตรง — ซึ่งเป็นจุดเจ็บปวดที่สำคัญสำหรับการจัดส่งอีคอมเมิร์ซ ที่อัตราการคืนสินค้าจากการจัดส่งผิดพลาดก่อให้เกิดต้นทุนมหาศาล หุ่นยนต์ที่ติดตั้งการรับรู้ mmWave สามารถตรวจสอบการมีอยู่และเรขาคณิตคร่าวๆ ของสินค้าก่อนปิดกล่อง โดยไม่ทำให้สายการผลิตช้าลง
การปรับใช้อย่างชาญฉลาดสำหรับ Cobots และ AMR
ความสามารถในการทำแผนที่ห้องด้วยเรดาร์ตัวเดียวของ RISE มีผลกระทบทันทีสำหรับ หุ่นยนต์เคลื่อนที่อัตโนมัติ (AMRs) และ cobots ที่ใช้งานในพื้นที่ที่ใช้ร่วมกับมนุษย์ แนวทางการติดตามมนุษย์ในปัจจุบันต้องการการครอบคลุมกล้องหนาแน่น (พร้อมปัญหาความเป็นส่วนตัวที่เกี่ยวข้อง) หรือเซ็นเซอร์ที่ติดตั้งบนตัวหุ่นยนต์ที่เคลื่อนที่เอง เรดาร์ที่อยู่กับที่ซึ่งสร้างแบบจำลองเชิงพื้นที่สดของห้อง — รวมถึงตำแหน่งมนุษย์ — จากการวิเคราะห์สัญญาณผีสามารถเปิดใช้งานการทำงานของ cobot ที่ปลอดภัยและตอบสนองมากขึ้นในสภาพแวดล้อมที่เปลี่ยนแปลง
สำหรับทีมที่ประเมินหุ่นยนต์สำหรับการประยุกต์ใช้งานเหล่านี้ ควรสำรวจ หุ่นยนต์อุตสาหกรรมมือสอง และ cobots ที่มีอยู่ใน Robot Overflow ในขณะที่ติดตามว่าระบบการรับรู้เช่น Wave-Formatter พัฒนาไปสู่การรวมในเชิงพาณิชย์อย่างไร
เส้นเวลาในการปรับใช้
ทั้งสองระบบอยู่ในขั้นตอนการวิจัย โดยมีผลลัพธ์ที่จะนำเสนอใน IEEE Conference on Computer Vision and Pattern Recognition งานวิจัยนี้ได้รับการสนับสนุนจาก NSF, MIT Media Lab และ Amazon — ซึ่งเป็นสัญญาณสำคัญของความสนใจในเชิงพาณิชย์ เป้าหมายถัดไปของทีมคือการสร้าง โมเดลพื้นฐานสำหรับสัญญาณไร้สาย คล้ายกับ GPT หรือ Gemini สำหรับภาษา ซึ่งจะเป็นก้าวสำคัญในการทำให้แนวทางนี้สามารถประยุกต์ใช้ข้ามสภาพแวดล้อมและประเภทวัตถุได้
คำถามที่พบบ่อย
Wave-Former คืออะไรและทำงานอย่างไร?
Wave-Former เป็นระบบที่พัฒนาโดย MIT ซึ่งใช้สัญญาณเรดาร์แบบมิลลิเมตรเวฟ (mmWave) เพื่อสร้างรูปร่าง 3 มิติของวัตถุที่ซ่อนอยู่หลังสิ่งกีดขวางเช่นกระดาษแข็ง ยิปซัม และพลาสติก มันสร้างการสร้างใหม่บางส่วนจากการสะท้อนเรดาร์ จากนั้นใช้โมเดล generative AI เพื่อเติมเต็มเรขาคณิตที่หายไป ในการทดสอบกับวัตถุในชีวิตประจำวันประมาณ 70 ชิ้น มันมีความแม่นยำสูงขึ้นเกือบ 20% เมื่อเทียบกับวิธีการล้ำสมัยก่อนหน้านี้
RISE สร้างห้องขึ้นมาใหม่โดยไม่ใช้กล้องได้อย่างไร?
RISE ใช้เรดาร์ mmWave ตัวเดียวที่อยู่กับที่และใช้ "สัญญาณผี" — การสะท้อนรองที่สะท้อนจากมนุษย์ที่เคลื่อนที่ในห้องแล้วสะท้อนจากเฟอร์นิเจอร์และผนังโดยรอบ ด้วยการติดตามว่าการสะท้อนหลายเส้นทางเหล่านี้เปลี่ยนแปลงอย่างไรเมื่อคนเคลื่อนที่ โมเดล generative AI จะอนุมานผังเชิงพื้นที่ของทั้งห้อง RISE แสดงให้เห็นความแม่นยำเชิงพื้นที่ประมาณสองเท่าของเทคนิคการสร้างฉากไร้สายที่มีอยู่ในการทดสอบมากกว่า 100 เส้นทาง
สิ่งกีดขวางใดที่สัญญาณ mmWave สามารถทะลุผ่านได้?
สัญญาณมิลลิเมตรเวฟ — ย่านความถี่เดียวกับที่ใช้ใน Wi-Fi — ทะลุผ่านวัสดุที่ไม่ใช่โลหะทั่วไปรวมถึงกระดาษแข็ง ไม้ ยิปซัม พลาสติก และผ้า พวกมันไม่ทะลุผ่านโลหะได้ดี ทำให้เหมาะสมสำหรับสภาพแวดล้อมคลังสินค้าที่สินค้าถูกบรรจุในกระดาษแข็งและพลาสติก แต่ใช้งานได้น้อยในสถานที่อุตสาหกรรมที่มีโลหะหนาแน่น
เทคโนโลยีนี้ช่วยรักษาความเป็นส่วนตัวได้ดีกว่ากล้องหรือไม่?
ใช่ เรดาร์ mmWave ไม่บันทึกภาพที่มองเห็นของบุคคลในสภาพแวดล้อม — มันตรวจจับเฉพาะการสะท้อนสัญญาณเท่านั้น ความสามารถในการทำแผนที่ห้องของ RISE ใช้การเคลื่อนที่ของมนุษย์เป็นแหล่งสัญญาณโดยไม่บันทึกข้อมูลภาพที่ระบุตัวตนได้ ซึ่งทำให้ได้เปรียบอย่างมีนัยสำคัญเหนือการทำแผนที่เชิงพื้นที่ด้วยกล้องในการปรับใช้ที่คำนึงถึงความเป็นส่วนตัว เช่น โรงพยาบาล บ้าน หรือสถานที่ทำงานที่มีกฎระเบียบ
เทคโนโลยีนี้จะพร้อมใช้งานในหุ่นยนต์เชิงพาณิชย์เมื่อใด?
ทั้ง Wave-Former และ RISE อยู่ในขั้นตอนการวิจัย โดยมีบทความจะถูกนำเสนอที่ CVPR Amazon เป็นหนึ่งในพันธมิตรผู้ให้ทุน ซึ่งบ่งชี้ถึงความสนใจในเชิงพาณิชย์ ทีม MIT ระบุว่าการสร้างโมเดลพื้นฐานสัญญาณไร้สายเป็นลำดับความสำคัญในการพัฒนาต่อไป การรวมในเชิงพาณิชย์ในระบบคลังสินค้าหรือ cobot อาจใช้เวลาหลายปี แต่ทิศทางสู่ฮาร์ดแวร์ที่ปรับใช้ได้นั้นชัดเจน
งานวิจัยนี้เป็นหนึ่งในความก้าวหน้าที่มีพื้นฐานในทางปฏิบัติมากที่สุดในการรับรู้ของหุ่นยนต์ในปีที่ผ่านมา — ไม่ใช่การปรับปรุงเกณฑ์มาตรฐานเพียงเล็กน้อย แต่เป็นการเปลี่ยนแปลงทางสถาปัตยกรรมที่แท้จริงในวิธีที่หุ่นยนต์สามารถสร้างแบบจำลองโลกรอบตัวพวกมัน Generative AI ไม่ได้เป็นเพียงเครื่องมือทางภาษาหรือภาพอีกต่อไป มันกำลังกลายเป็นเอนจินการอนุมานที่ทำให้ระบบทางกายภาพสามารถให้เหตุผลเกี่ยวกับสิ่งที่พวกมันไม่สามารถสังเกตได้โดยตรง